RLR-0101 ・ 公開 2026/11/17 ・ 更新 2026/11/17
llama.cpp v1.0.0公開。ローカルAIを動かす基盤は何が変わった?
llama.cppとggmlが11月13日にv1.0.0を公開。推論エンジンの役割、互換性ルール、新機能、ローカルAIを試す入口を公式資料から解説。
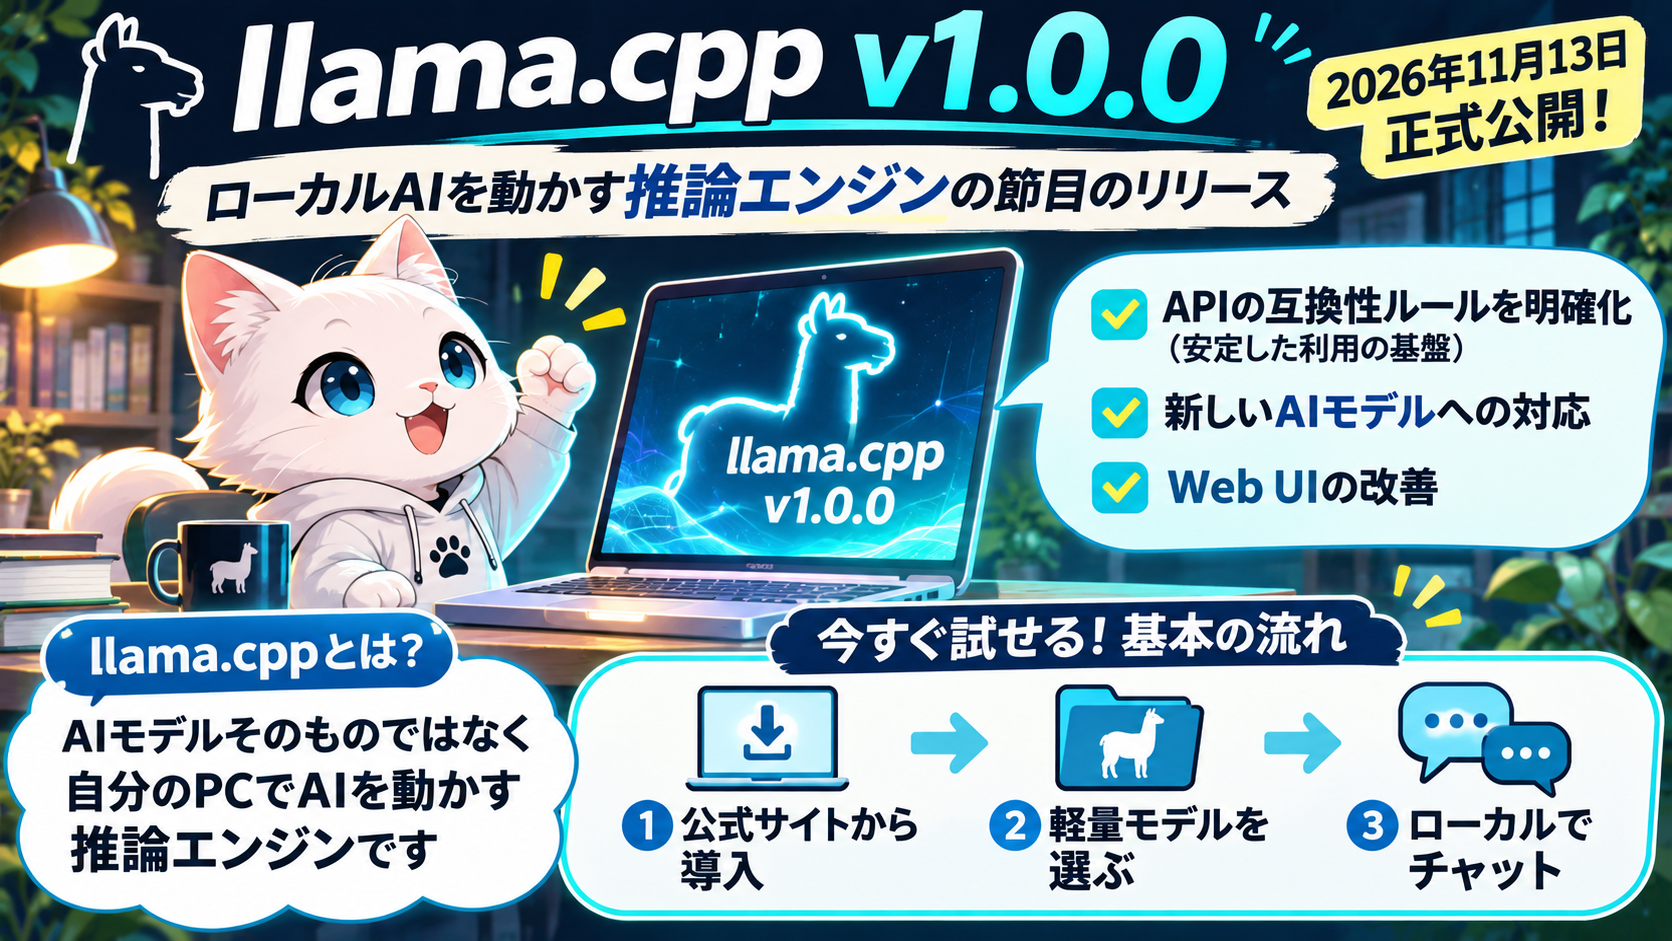
「ローカルAIを動かすソフト」と聞くと、OllamaやLM Studioを思い浮かべるかもしれません。その裏側を支える重要な技術の一つが llama.cpp(ラマ・シーピーピー) です。
2026年11月13日、開発チームのggml-orgが llama.cppとggmlのv1.0.0 を公開しました。2023年から育ってきたプロジェクトにとって、初の正式なメジャーバージョンです。
ただし「v1.0になったから手元のAIが一斉に高性能化する」という話ではありません。今回の大きな意味は、ローカルAIを動かす基盤の互換性ルールが明確になったことです。
llama.cppはAIモデルそのものではない
AIに質問するときは、回答するための「モデル」と、そのモデルをPCで動かす「推論エンジン」が必要です。
- AIモデル:文章の続きを予測して回答を作る仕組み。Qwenなどが例です。
- llama.cpp:モデルを読み込み、CPUやGPUを使って推論を実行するソフトウェアです。
- ggml:llama.cppの計算を支えるライブラリです。
llama.cppはC/C++で実装され、量子化されたモデルやさまざまなハードウェアを扱えるよう設計されています。公式発表では、150を超えるモデルアーキテクチャのバリエーションに対応すると説明しています。
つまり今回の主役は新しいチャットAIではなく、自分のPCでさまざまなAIを動かすための土台です。
v1.0.0で何が変わった?
1. バージョン番号で互換性の変化が分かる
開発チームは公開C APIの変更に対して、次のルールを明示しました。
| 更新の種類 | 意味 |
|---|---|
| メジャー(1.x → 2.xなど) | 公開C APIの互換性が失われる変更 |
| マイナー(1.0 → 1.1など) | 互換性を保つ機能追加、モデル・バックエンド対応 |
| パッチ(1.0.0 → 1.0.1など) | APIを変更しない不具合修正 |
これは主に、llama.cppを自作アプリに組み込む開発者にとって重要な約束です。CLIオプションやWeb UIの動作が今後一切変わらないという保証ではありません。
なおv1.0.0自体では、過去に非推奨となっていたAPIの削除など、互換性に影響する変更も実施されています。独自アプリに組み込んでいる人はリリースノートを確認しましょう。
2. 新しいモデルや音声機能への対応
公式リリースノートでは、Kimi-K3.1-Pro、Ripple-65B-Preview、xing4_0などのモデルアーキテクチャへの対応、drama-3の音声生成、FP8 KVキャッシュ、MoE関連の改善が案内されています。
ただし**「エンジンが対応した」ことと「自分のPCで快適に動く」ことは別**。必要なRAM・VRAM、量子化版の有無、モデルのライセンスは個別に確認しましょう。
3. Web UIも使いやすく
チャットのグループ分け、長文を扱えるMarkdown編集欄、スマートフォン向けの画面調整なども含まれています。
これらはllama.cppに含まれるWeb UIの変更であり、LM StudioやOllamaの画面が同じように更新されるという意味ではありません。
初心者が自分のPCで試すには?
公式READMEには、公式サイトからの導入、ビルド済みファイルのダウンロード、Docker、ソースコードからのビルドなど複数の方法が紹介されています。
- 公式サイト llama.app または公式GitHubを開き、使用するOS向けの導入方法を確認します。
- 最初は大きなモデルを選ばず、軽量なGGUFモデルを試します。公式READMEには Qwen3.5-0.8B-GGUF を利用する例があります。
- 導入済みの環境では、公式READMEの例に従ってコマンド「llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF」でモデルを取得してチャットを開始できます。
上のコマンドは公式READMEに掲載された例です。インストール方法や実行ファイル名はOS・配布形態・バージョンで変わる場合があるため、画面に表示される案内を優先してください。インストールスクリプトを実行する場合は、リンク先の内容を確認してから実行しましょう。
軽量モデルでも必要メモリは実行設定で変わります。「0.8Bなら必ず低スペックPCで動く」とは断定できません。 また今回の記事では、v1.0.0の速度や日本語回答品質を実測していません。
LM StudioやOllamaを使っている人は更新が必要?
今すぐ何かを入れ直す必要がある、と一律には言えません。
llama.cppはローカルAIの基盤技術ですが、各アプリがどの版を採用し、どう組み込んでいるかはアプリ側の判断です。llama.cpp v1.0.0の公開だけを理由に、LM StudioやOllamaを手動で置き換えないようにしましょう。
普段は使い慣れたアプリの公式アップデート案内を確認し、llama.cppを直接利用・組み込みしている場合にv1.0.0の変更点を詳しく読むのがおすすめです。
まとめ
llama.cpp v1.0.0は、モデルそのものの発表ではなく、ローカルAIを動かす推論エンジンの節目です。開発者向けの互換性ルールが明確になり、新モデル対応やWeb UI改善も進みました。
これからローカルAIを試したい人は、まず公式の導入手順と軽量モデルから。すでにLM Studioなどを使っている人は、各アプリの更新情報を見ながら、自分に必要な変更だけ取り入れていけば大丈夫です。
一次情報
SOURCES