RLR-0059 ・ 公開 2026/10/29 ・ 更新 2026/10/29
LFM3-Omni-2Bを日本語で使うには?OllamaのWindows対応・GGUF容量・音声と動画の注意点
Liquid AIの小型マルチモーダルAI「LFM3-Omni-2B」を解説。日本語の音声・写真・動画の理解、Ollama 0.40.13のWindows/Linux対応、GGUF容量と追加ファイル、アプリごとの制限を整理します。
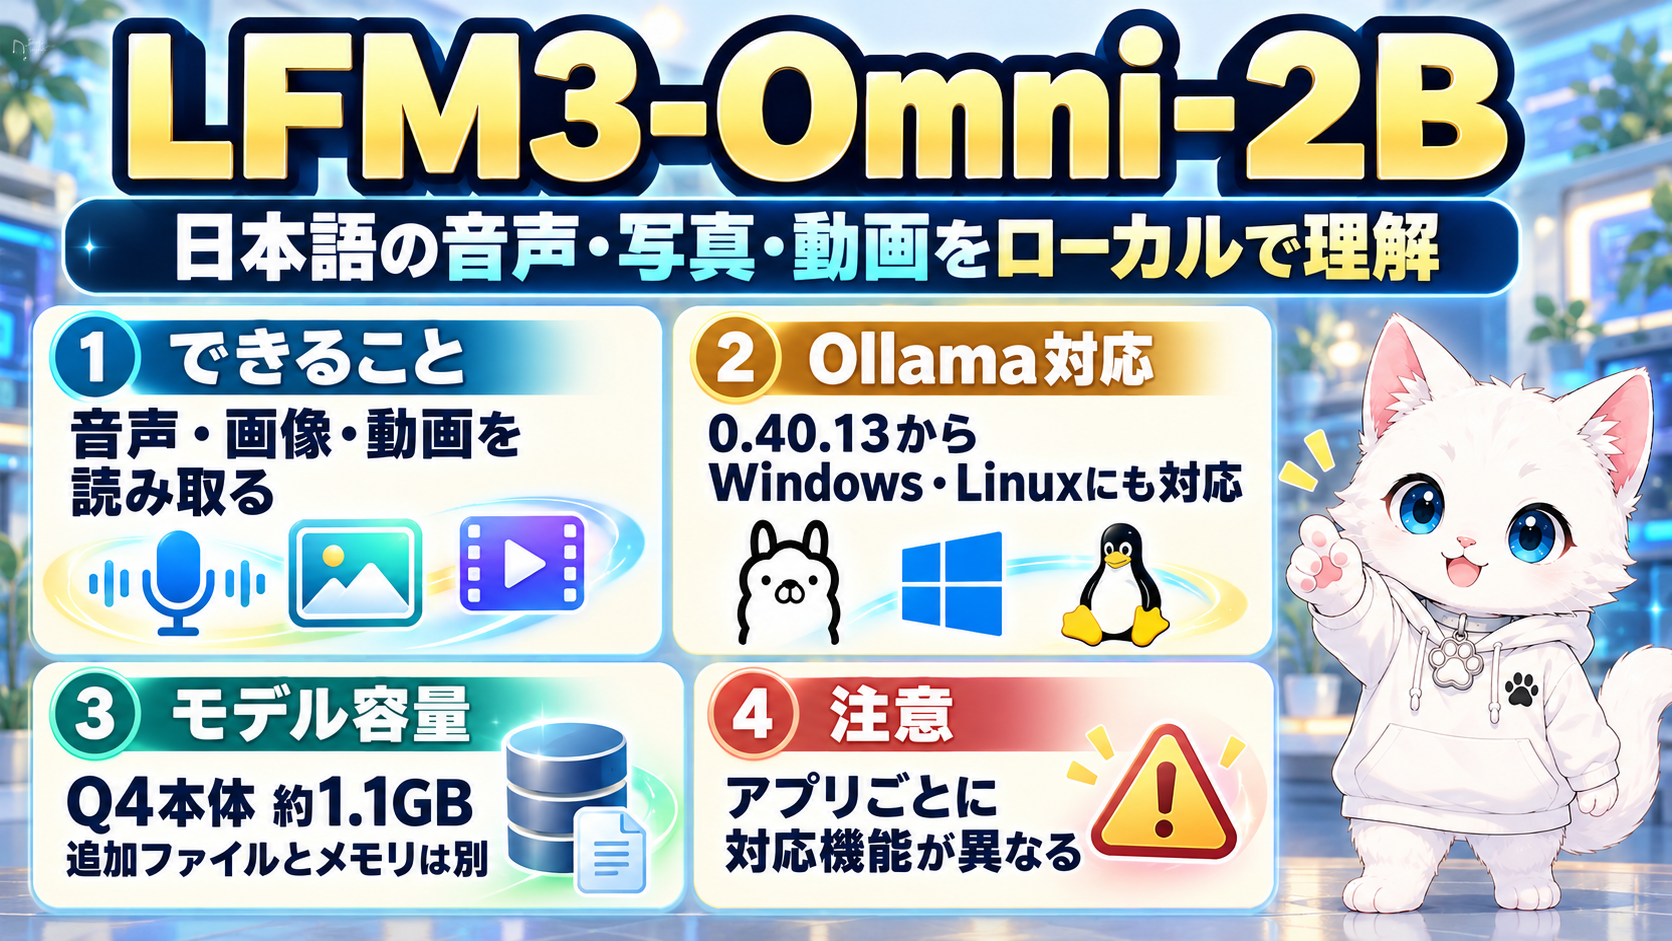
LFM3-Omni-2Bは、写真・動画・音声を読み取って、文章や音声で答えられる小型のローカルAIモデルです。 日本語も公式の対応言語に含まれます。さらに、2026年10月28日(UTC)公開のOllama v0.40.13で、LFM3シリーズは従来のApple siliconに加えてWindows・Linuxでも実行可能になりました。
ただし、「Ollamaでモデルを起動できる」ことと「Windows版の画面から音声・動画の全機能を同じように使える」ことは別です。最初に用途と対応アプリを確認すると、不要なダウンロードや設定のやり直しを避けられます。
LFM3-Omni-2Bで何ができる?
Liquid AIの公式モデルカードによると、モデルは約21.7億パラメータ(2.17B)。文章、写真、音声、既存動画(映像と音声トラック)を入力し、文章または音声で応答する設計です。
| 入力 | 想定する使い方 | 注意点 |
|---|---|---|
| 文章 | 日本語で質問して文章で回答 | 回答の正確性は保証されない |
| 写真 | 写っている物や状況を質問 | 小さな文字や細部は誤認識し得る |
| 音声 | 日本語の発話を文字起こし・翻訳 | 音質や話者数で結果が変わる |
| 既存動画 | 映像と音を合わせて内容を質問 | 動画生成ではなく、動画の理解が目的 |
「Omni」は複数の入力を一つのモデルで扱えることを意味します。テキストから新しい映像を生成する動画生成AIではありません。 例えば、自分で撮影した短い動画を読み込ませ、「画面では何が起きていて、どんな音が聞こえる?」と質問する用途です。
モデルカードでは、日本語がテキストと音声の両方の対応言語に挙がっています。ただし日本語の認識精度や自然な読み上げ品質は今回実測していません。対応言語の記載を、すべての録音で高精度に動く保証と受け取らないでください。
OllamaはWindows・Linuxでも使えるようになった?
はい。モデル実行のOS対応は拡大しました。 Ollama v0.40.13の公式リリースは、LFM3系がApple siliconに加えてWindowsとLinuxで動作し、lfm3-audioとlfm3-omniの音声合成も含むと明記しています。
Ollamaを対応版へ更新したうえで、モデルを取得して起動する基本コマンドは次のとおりです。
ollama run lfm3-omniOllamaのモデル配布ページはlfm3-omniです。ダウンロード容量、実行時のメモリ、入力できる形式は別々に確認してください。
ここでの注意は、モデルの実行対応と、写真・動画・マイク入力を受け付ける操作画面/APIの対応範囲は同じではないこと。公式リリースだけでは、Windows・Linux・macOSのすべてで音声入力、動画入力、音声出力が同じUI操作で使えるとは確認できません。用途ごとに実行アプリの説明を参照しましょう。
llama.cpp・LM Studio・Ollamaはどう選ぶ?
Liquid AI公式GGUFガイドに記載された、2026年10月29日時点の選択目安です。
| 実行方法 | 公式に確認できる入口 | こんな人向け |
|---|---|---|
| Ollama | v0.40.13以降はLFM3系をWindows・Linux・Apple siliconで実行 | まずモデルを起動して試したい人 |
| LM Studio | Windows/macOS/Linux、llama.cpp engine 2.65.1以降で画像入力を案内 | GUIで写真について質問したい人 |
| Llama.app | Windows/macOSで画像・音声・動画入力を案内 | 複数の入力形式を試したい人 |
| llama.cpp | v0.8.0以降、CPU/GPUでのローカル推論、音声・動画向けCLI例 | コマンドやAPIを調整したい人 |
LM Studioに「画像入力」と書かれていることから、音声・動画まで同じように使えると推測しないことが大切です。またOllama公式リリースはOS対応を更新していますが、Liquid AI側のGGUFガイドには以前のmacOS中心の説明が残っています。OS対応の新しい情報はOllama v0.40.13、各機能の操作方法は利用するアプリのガイドを優先して確認しましょう。
llama.cppでGGUFを直接試す場合、公式ガイドの基本例は次の形です。最初の実行時にはモデル本体だけでなく画像・音声用のprojectorもダウンロードされます。
llama serve -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --reasoning off --temp 0 --port 8080このコマンドは対応するllama.cppが導入済みであることが前提です。動画入力にはffmpegをPATHから使える状態にする必要があります。CLIのオプションや利用できる入力形式はバージョンで変わるため、公式の実行例と照合してください。
1.1GBならメモリも1.1GBで足りる?
いいえ。1.1GBは量子化モデル本体のファイルサイズであり、必要RAM/VRAMの確定値ではありません。
公式GGUFのモデル本体は、4bitのQ4_K_Mが約1.1GB、8bitのQ8_0が約1.85GBです。画像・音声の処理には追加のprojectorが必要で、実行時にはコンテキスト、画像・動画フレーム、アプリ本体などのメモリも使います。Ollamaで配布されるモデルの容量と、Hugging Face上の単一GGUFファイルの容量も同一とは限りません。
モデルの公称コンテキストは32Kトークン。動画は標準で毎秒2フレーム、4〜384フレームを取り出して処理するため、動画全体を一切間引かずに見るわけではありません。長い動画ほど必要な処理量やメモリが増える可能性があります。
CPUで動かす経路も公式に用意されていますが、最低RAM/VRAM、快適な速度、低VRAMでの実効性能はここでは確認できていません。まず短いテキストや画像で起動を確認し、音声・動画は小さな素材から試すのが安全です。
無料で使える?商用利用は?
公開モデルを自分のPCで実行する場合、通常はクラウドAPIのような推論ごとの従量課金は不要です。ただしダウンロード、保存領域、電力、機材などの費用は別です。外部のクラウド実行サービスを選べば、そのサービスの料金がかかる場合があります。
モデルのライセンスはApache 2.0そのものではなく、LFM Open License v1.0です。Liquid AIのライセンス説明によると、商用利用は原則可能ですが、企業の年間売上が1,000万米ドルを超える場合、継続的な商用利用には別途ライセンス契約が必要です。モデルを再配布する場合の表示義務などもあります。事業用途では原文を確認してください。
また、ローカルで推論することと、利用するアプリやプラグインが外部通信を一切しないことは別です。機密の録音や動画を扱うときは、使用する実行経路の通信設定とデータの扱いを確認しましょう。
最初に試すなら、この順番
- 目的を決める。 文章・写真の質問か、日本語の音声認識か、動画の映像と音を合わせた解析かを先に選ぶ。
- 対応アプリを選ぶ。 手軽なモデル起動ならOllama、画像のGUI操作ならLM Studio、音声・動画入力なら公式対応が明記されたLlama.appやllama.cppを検討する。
- 容量と環境を確認する。 GGUF本体の容量に加えてprojector、空きメモリ、必要ならffmpegを確認する。
- 短い自作素材で確認する。 日本語の短い録音や数秒の動画で、認識精度と実行時間を自分の環境で測る。
結論:LFM3-Omni-2Bは「小さなローカルAIに写真・声・動画を理解させたい」人に有力な新しい選択肢です。 Windows・LinuxでOllamaから起動できるようになったことは大きな前進ですが、入力形式ごとの対応、追加容量、日本語品質、商用条件を確認してから使い始めましょう。
公式資料
SOURCES