RLR-0071 ・ 公開 2026/11/01 ・ 更新 2026/11/02
MiniCPM-OCR 1.0とは?Ollamaで画像の文字・表・数式を読む方法とPDF・日本語の注意点
2026年10月28日に発表されたMiniCPM-OCR 1.0を初心者向けに解説。Ollamaで公式GGUFを試す手順、Q4約0.529GBと必須画像projector約0.901GBの違い、PDFのMarkdown化に追加SDKが必要な理由、日本語認識の未確認事項を整理します。
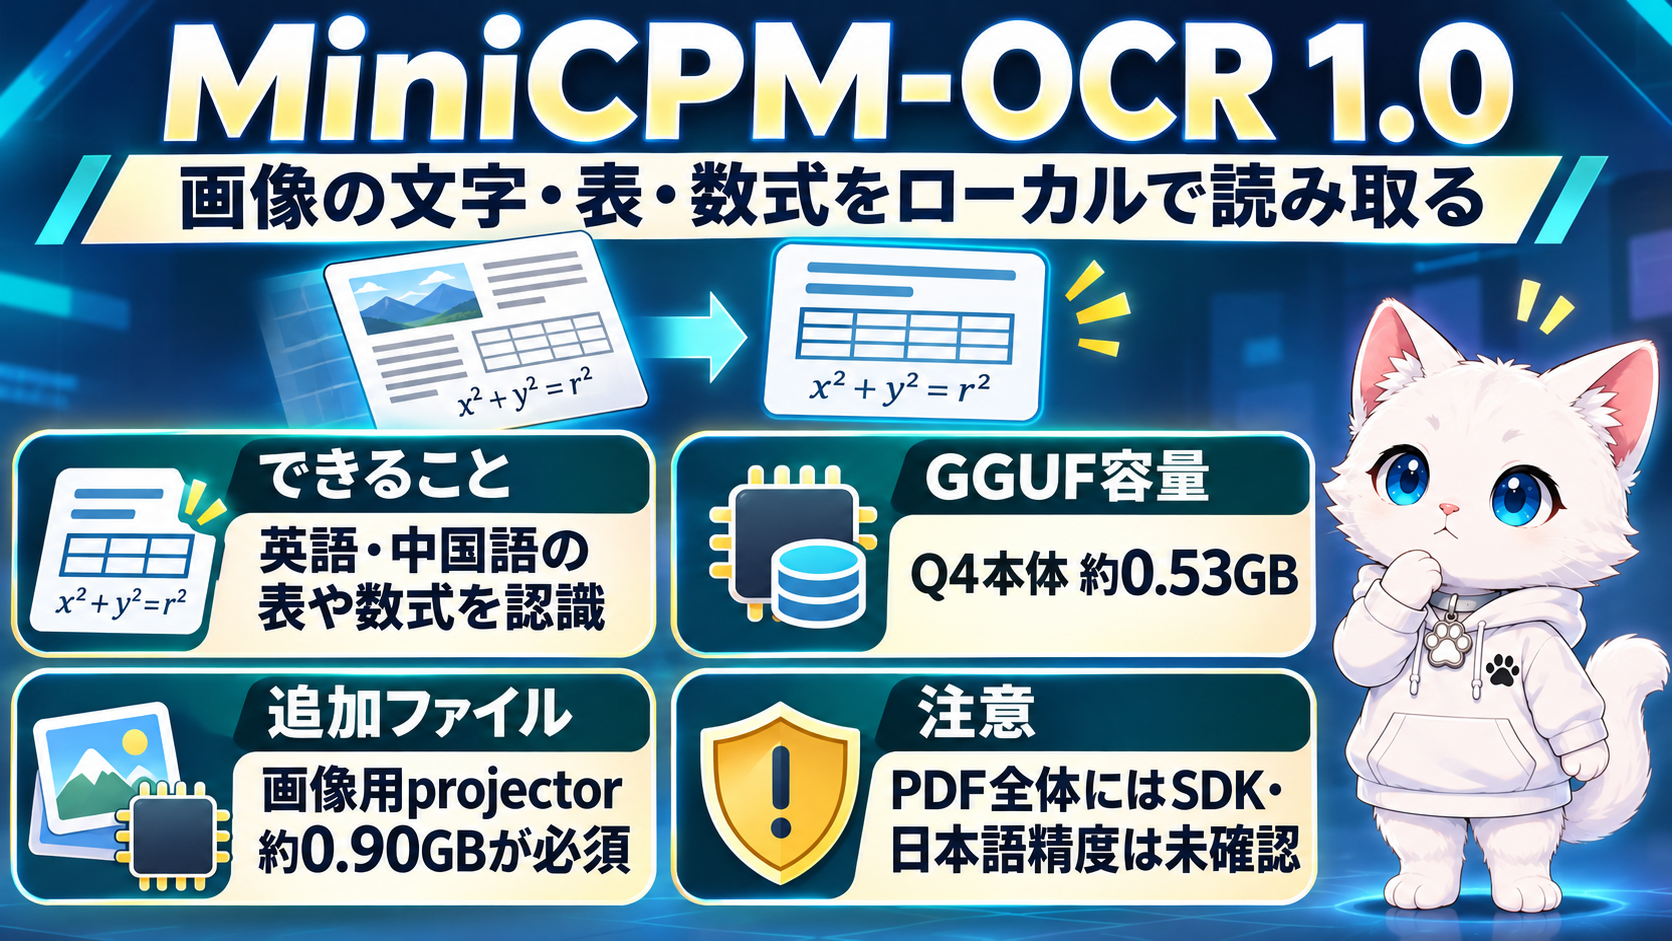
「紙の資料を撮った画像から、文字だけでなく表や数式も取り出せたら便利なのに」。そんな用途に向けた新しいローカルAIが、OpenBMBの MiniCPM-OCR 1.0 です。
2026年10月28日に発表された約13億パラメータ(1.3B)のOCR専用モデルで、画像内の文字、表、数式、図表などを認識します。OCRとは、画像に写った文字を編集可能なテキストへ変換する技術です。
先に重要な点を3つ。公式が主に対象としているのは英語・中国語で、日本語の読み取り精度は未確認です。Ollamaで画像1枚を試すことと、PDF全ページをMarkdownへ整理することは別の作業です。そして小さなGGUFファイルだけでは画像を読めず、別のvision projectorも必要です。
この記事はOpenBMB公式モデルと公式GGUF配布を2026年11月2日に確認した内容です。Rossy Laboratoryでの実機推論結果ではありません。
何ができる?普通の文字起こしとの違い
MiniCPM-OCR 1.0は、単に文字を1列に抜き出すだけでなく、書類の構造を扱うことを目指したモデルです。公式が挙げる主な対象は、英語・中国語の文書、写真に写った書類、傾いたスキャン、表、数式、グラフ、印影など。
| 読みたいもの | 期待できる出力・用途 | 注意 |
|---|---|---|
| 英文の写真・スキャン | 文字をテキスト化 | ぼけ・小さな文字は誤認識し得る |
| 表 | 行・列の構造を保った認識 | セル結合や細かい罫線は要確認 |
| 数式 | 数式の構造を認識 | 記号1文字の違いでも意味が変わる |
| PDF全体 | レイアウト解析とMarkdown化 | 別途SDKとレイアウトモデルが必要 |
Markdownは、見出しや表を記号で表す軽量な文書形式です。認識結果を後から編集したり、検索・整理したりする際に便利です。
開発元は複数の文書認識ベンチマークで高い評価値を報告していますが、作者が示した条件での測定です。読者の手元のスキャンや日本語資料で同じ精度になるという意味ではありません。
まず確認したいGGUFの容量
GGUF は、ローカルAIをOllamaやllama.cppなどで動かす際に使われるモデルファイル形式です。公式GGUFには複数の量子化版があり、量子化によってファイルを小さくできます。
| 公式配布ファイル | ダウンロードサイズの目安 | 役割 |
|---|---|---|
| Q4_K_M | 0.529GB | 小さめの文字認識モデル |
| Q8_0 | 0.812GB | 細かい文字やコードを扱う際の比較候補 |
| F16 | 1.516GB | 非量子化の比較基準 |
| mmproj-model-f16-4x.gguf | 0.901GB | 画像入力に必須のvision projector |
vision projectorは、画像の情報を言語モデルが扱える形につなぐ部品です。Q4_K_Mとprojectorの2ファイルだけでも合計約1.43GBになります。0.529GBだけで画像OCRが完成するわけではありません。
さらに、ダウンロード容量と実行時のGPU VRAM・PC RAMは別です。入力画像の大きさ、処理する文書、コンテキスト長、使用するバックエンドによってメモリ消費は変わります。モデルが小さいからGPU不要・必ず低メモリで動くとは断定できません。
公式GGUFの説明では、Q4_K_Mは表の認識に比較的強い一方、密集した文字やXMLの閉じタグなどで劣化する場合があり、コードやXMLが多い文書にはQ8_0を推奨しています。
Ollamaで試す最初の一歩
Ollamaが使える環境なら、公式GGUFページに掲載された次のコマンドが入口です。
ollama run hf.co/openbmb/MiniCPM-OCR-1.0-gguf:Q4_K_M初回はファイルのダウンロードが発生します。公式配布ページでは、このOllama経路に加え、llama.cppでモデル本体とprojectorを明示して使う方法も説明しています。Ollama側の自動取得・画像添付の対応は使用バージョンや実行環境で異なるため、画像が読めないときはprojectorの取得・認識状況とランタイムの対応を確認してください。
試す画像は、まず個人情報を含まない、はっきり写った英語の表1枚がおすすめです。対応する画像入力機能から添付し、認識を試します。llama.cppの公式例では、用途ごとに次の短い指示を使い分けます。
Text Recognition::文字・段落の認識Table Recognition::表の認識Formula Recognition::数式の認識
たとえば英語の表なら、元画像と出力を見比べて、行・列・数値が正しく残っているかを確認します。読み取った数字をそのまま請求書や集計に転記する前に必ず照合してください。
より直接的にprojectorを指定して試したい場合は、公式GGUFページのllama.cpp実行例を参照できます。以下は公式が掲載する単一画像向けの形式です。ファイル名とパスは実際の保存場所に合わせます。
llama-mtmd-cli -m ./MiniCPM-OCR-1_0-Q8_0.gguf \
  --mmproj ./mmproj-model-f16-4x.gguf \
  --image page.png -p "Text Recognition:" \
--jinja -ngl 99 -c 8192 --temp 0このコマンドはllama.cppの対応ビルドが必要で、すべてのWindows環境で動作確認済みという意味ではありません。GPUオフロード指定やパスは環境に応じて調整してください。
PDFを丸ごとMarkdownにしたい場合は?
ここが混同しやすいところです。Ollamaで画像1枚を読み取れたからといって、PDFの全ページを自動でレイアウト分割してMarkdownへ再構成できるわけではありません。
OpenBMBの公式SDKは、PDFや画像を受け取り、PP-DocLayoutV3などのレイアウト検出、領域ごとのOCR、読み順に沿った結果の組み立てを行う仕組みです。SDKには追加モデル・依存ライブラリ・対応する認識サーバーが必要です。
公式のSDK CLI資料では、PDFを入力してMarkdownを書き出す例を案内しています。導入時は公式の環境構築手順を先に確認し、モデル本体だけを入れて完了したと思わないようにしましょう。
| 目的 | まず使うもの |
|---|---|
| 表が写った画像を1枚試す | 公式GGUF+projector、対応Ollamaまたはllama.cpp |
| PDFの複数ページをMarkdown化する | 公式SDK+レイアウトモデル+認識バックエンド |
| 日本語の書類を大量処理する | 日本語での実測が必要。対応を前提にしない |
PDFには画像だけでなく、最初から選択できるテキストが埋め込まれている場合もあります。その場合は、いきなりOCRを使わず、既存テキストを取り出す方が簡単なことがあります。
日本語・プライバシー・精度の注意点
- 日本語の精度は未確認:公式が主な対象言語として挙げるのは英語・中国語です。日本語、縦書き、手書き文字を高精度に読めると断定しません。
- 数値や数式は人が再確認:小数点、マイナス、単位、表の列ずれなどは一文字の誤りが大きな問題につながります。
- ローカルでも保存先に注意:クラウドAPIを使わず動かす経路はありますが、入力画像・ログ・生成したMarkdownの保存場所、共有設定は自分で確認してください。
- ライセンス:公式モデル・コードはApache-2.0表記です。利用・再配布時はライセンスの条件を確認してください。
- 実測はこれから:この記事のファイル容量は公式配布情報です。Rossy LaboratoryのRTX 4090でのVRAM、速度、精度は未測定です。
まとめ:最初は英語の表1枚から
MiniCPM-OCR 1.0は、英語・中国語のスキャン文書や表・数式をローカルで読み取りたい人にとって、試す価値のある新しいOCRモデルです。
ただし、Q4約0.529GBという数字だけで選ばないこと。画像入力には約0.901GBのprojectorも必要で、PDF全体をMarkdownへ変換するならSDKなどが追加で必要です。
まずは個人情報のない英語の表を1枚読み取り、元画像と結果を比べてみましょう。日本語資料への本格導入は、実際の認識精度を確認してから判断するのが安全です。
参照した一次情報(2026年11月2日確認)
SOURCES