RLR-0073 ・ 公開 2026/11/02 ・ 更新 2026/11/02
録音の雑音を38MBのローカルAIで除去!NVIDIA RE-USE×speech.cppのWindows導入と注意点
NVIDIA NemotronLabs RE-USEを、speech.cpp 0.10.1のWindows Vulkan版で使う方法を解説。約38.5MBの音声用GGUF、WAVの処理コマンド、会議録音や日本語文字起こしでの副作用、未検証事項まで整理します。
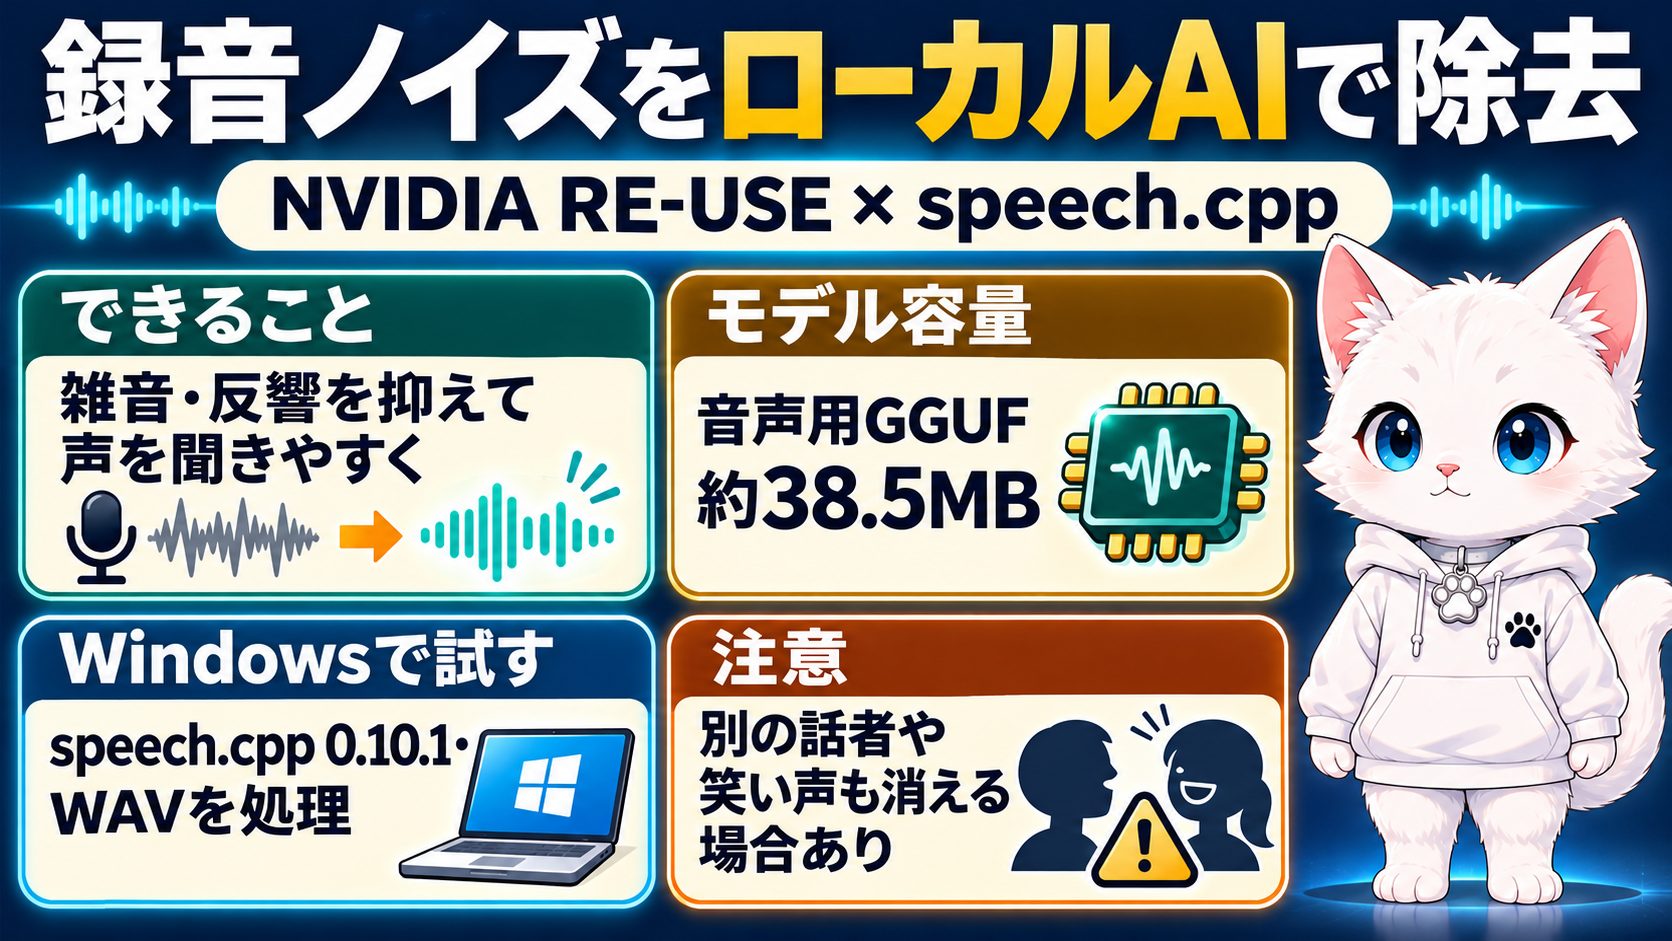
「録音の声は聞こえるのに、ファンの音や部屋の反響で聞き取りにくい……」。動画のナレーションやボイスメモで、そんな困りごとはありませんか。
NVIDIA NemotronLabs RE-USE は、録音済みの音声から雑音や反響などを抑えるための小型AIモデルです。2026年10月22日に公開された元モデルに加え、11月1日(UTC)にはコミュニティの軽量GGUFと、Windows用の実行ファイルを含むspeech.cpp v0.10.1が揃いました。Python環境を一から構築せず、コマンドでWAVを処理する選択肢が増えています。
この記事は2026年11月2日時点の開発元NVIDIAとspeech.cppの公開資料を確認した導入ガイドです。Rossy Laboratoryでの実機成功報告ではありません。
何ができる?「声を作るAI」ではなく「録音を整えるAI」
RE-USEが扱うのは、すでに録音した声です。文章からナレーションを作るTTSとは違い、入力した音声を加工して聞き取りやすくすることを目指します。
NVIDIAが挙げる対象には、背景の雑音、部屋の残響、音割れ、電話のような狭い周波数帯域、圧縮による劣化、品質の低いマイクなどがあります。何でも元通りに復元できるという意味ではありません。 声の一部が弱くなったり、音の印象が変わったりする可能性もあります。
| 確認したいこと | 2026年11月2日時点の情報 |
|---|---|
| 元モデル | NVIDIA NemotronLabs RE-USE、約960万パラメータ |
| 変換済みモデル | speech.cpp向けF32 GGUF、約38.5MB |
| 入出力 | WAV音声(NVIDIA公式の入力仕様はモノラル、8〜48kHz) |
| Windowsの入口 | speech.cpp v0.10.1のWindows x64 Vulkan版 |
| 課金 | ローカル処理にAPI従量課金は不要。初回取得にはネット接続が必要 |
| 動作確認 | Windows / RTX 4090での速度・VRAM・音質は今回未測定 |
38.5MBはモデルファイルの容量です。実行中のRAMやGPUメモリが38.5MBで済むという意味ではありません。また、このGGUFは音声処理用の専用形式で、OllamaやLM Studioに一般的な会話LLMとして読み込ませるものではありません。
Windowsで試す手順
必要なのは、speech.cpp v0.10.1の配布ページから取得するWindows用実行ファイルと、自分で録音した短いWAVです。
- GitHubのReleaseから Windows x64 Vulkan版(
speech-0.10.1-windows-x64-vulkan.zip)を取得して展開します。実行ファイルspeech.exeの場所を確認してください。 - 自分で録音した雑音入りの短い音声を、例えば
noisy.wavとして用意します。最初はモノラルWAVを使うと、入力条件を切り分けやすくなります。 - 展開したフォルダでPowerShellを開き、次のコマンドを実行します。
.\speech.exe enhance re-use noisy.wav -o clean.wav- 初回はモデルをネット経由で取得する場合があります。処理が終わったら
clean.wavと元のnoisy.wavを同じ音量で聞き比べます。
speech.cppの公式手順では、re-use というモデル名を指定して処理できます。speech.exe はWindows版の実行ファイル、re-use は音声修復モデル名です。PowerShellで speech が見つからない場合、展開先に移動して .\speech.exe を使っているか確認しましょう。
注意: NVIDIA公式のPython版モデルカードはLinux環境を案内しています。ここで紹介しているWindowsの方法は、NVIDIA公式のWindowsアプリではなく、第三者のspeech.cpp実装です。Vulkan対応GPUとドライバーの組み合わせによって動作可否は異なります。事前に大事な音声のバックアップを残してください。
処理後に確認する3つのポイント
1. 雑音だけでなく声も変わっていないか。 ファン音が小さくなっても、語尾や小さな声、子音が欠けていたら用途によっては逆効果です。原音は上書きせず残します。
2. 複数人の会話が消えていないか。 NVIDIAによると、声が重なる場面では主な話者を残し、ほかの話者を抑えるよう学習されています。会議の全員の発言を残したい場合には、むしろ不向きなことがあります。
3. 笑い声まで消えていないか。 笑い声を残したい用途には、別の re-use-laughter モデルも用意されています。通常版と結果を比較してください。
文字起こしの前処理に使うなら、必ず結果を比較
「雑音を減らせば日本語の文字起こし精度も必ず上がる」とは限りません。
speech.cpp作者の検証では、雑音を重ねた日本語FLEURS音声の一条件で文字誤り率(CER)が 9.99% → 9.06% に改善した一方、日本語テレビ音声のReazonSpeechでは 4.69% → 8.36% に悪化した例も報告されています。どちらも作者の特定データセット・条件での測定で、一般的な改善率ではありません。
大切な会議やインタビューなら、まず短い区間で「加工前と加工後の音声」と「文字起こし結果」の両方を確認するのがおすすめです。
うまく動かないとき
- コマンドが見つからない:PowerShellの現在位置と
speech.exeの実在を確認します。フォルダを移動しただけでPATHには登録されません。 - GPU関連のエラー:Windows版はVulkanバックエンドです。GPU・ドライバー・配布アーカイブの種類を確認します。CPUのみのWindows版が同梱されているとは断定できません。
- モデルの取得で止まる:初回のネット接続と配布元へのアクセスを確認します。GGUFを手動取得する場合はspeech.cpp向けのファイルを選びます。
- 結果が不自然:元のWAVを残し、まず短い音声、少ない話者、別の録音条件で比較します。音割れや欠損が必ず復元されるわけではありません。
なお、--bwe 48000 は48kHzへリサンプリングしたうえで帯域を補う別の設定です。基本のノイズ除去と混同せず、最初は付けずに比較すると分かりやすいでしょう。
商用利用・プライバシーの注意
NVIDIAの元モデルは OpenMDW-1.1 で、公式モデルカードには商用利用可能との説明があります。ただし、実際の利用前にライセンスの条件を確認してください。モデルの重みのライセンスとspeech.cppのプログラムのライセンスは別です。
初回ダウンロードはネット通信が必要でも、処理自体は自分のPC上で行う構成です。とはいえ、録音データに他人の声や個人情報が含まれる場合は、利用許諾と保管方法を確認しましょう。
まとめ:まずは10秒の自分の録音で比較
RE-USEは「小さなモデルで、録音を聞きやすくできるか試す」ための新しいローカル選択肢です。2026年11月2日時点では、speech.cppのWindows配布とGGUFによって試す入口が広がりました。
まずは自分で録った短いWAVを加工し、雑音・声の自然さ・笑い声・別話者の声を聞き比べてください。モデル容量だけで必要メモリや品質を判断せず、実機で確認した結果を優先するのが確実です。
参照した一次情報
SOURCES
確認した情報源
- NVIDIA:NemotronLabs RE-USE公式モデルカード一次情報 ・ 確認 2026/11/02情報源を開く ↗
- speech.cpp:v0.10.1リリース一次情報 ・ 確認 2026/11/02情報源を開く ↗
- speech.cpp:SEMamba / RE-USE利用手順と評価一次情報 ・ 確認 2026/11/02情報源を開く ↗
- sakasegawa:NemotronLabs RE-USE GGUF変換版一次情報 ・ 確認 2026/11/02情報源を開く ↗
- sakasegawa:RE-USE laughter GGUF変換版一次情報 ・ 確認 2026/11/02情報源を開く ↗