RLR-0091 ・ 公開 2026/11/13 ・ 更新 2026/11/13
Edge0 145Bとは?巨大ローカルLLMを単一GPUで動かす仕組みと必要メモリを解説
Edge0 145B / 120Bは、Qwen3.8-Flash-Next由来のlatent MoEを単一NVIDIA GPUで動かすためのローカルLLMです。145B Q3_Kは40.81GiBの重みを持ちながら、必要なexpertをGPU側へ配置して残りをホストメモリから扱う設計です。公式の16GiB VRAM+20GiB RAM制限テストの意味、Windows要件、注意点を整理します。
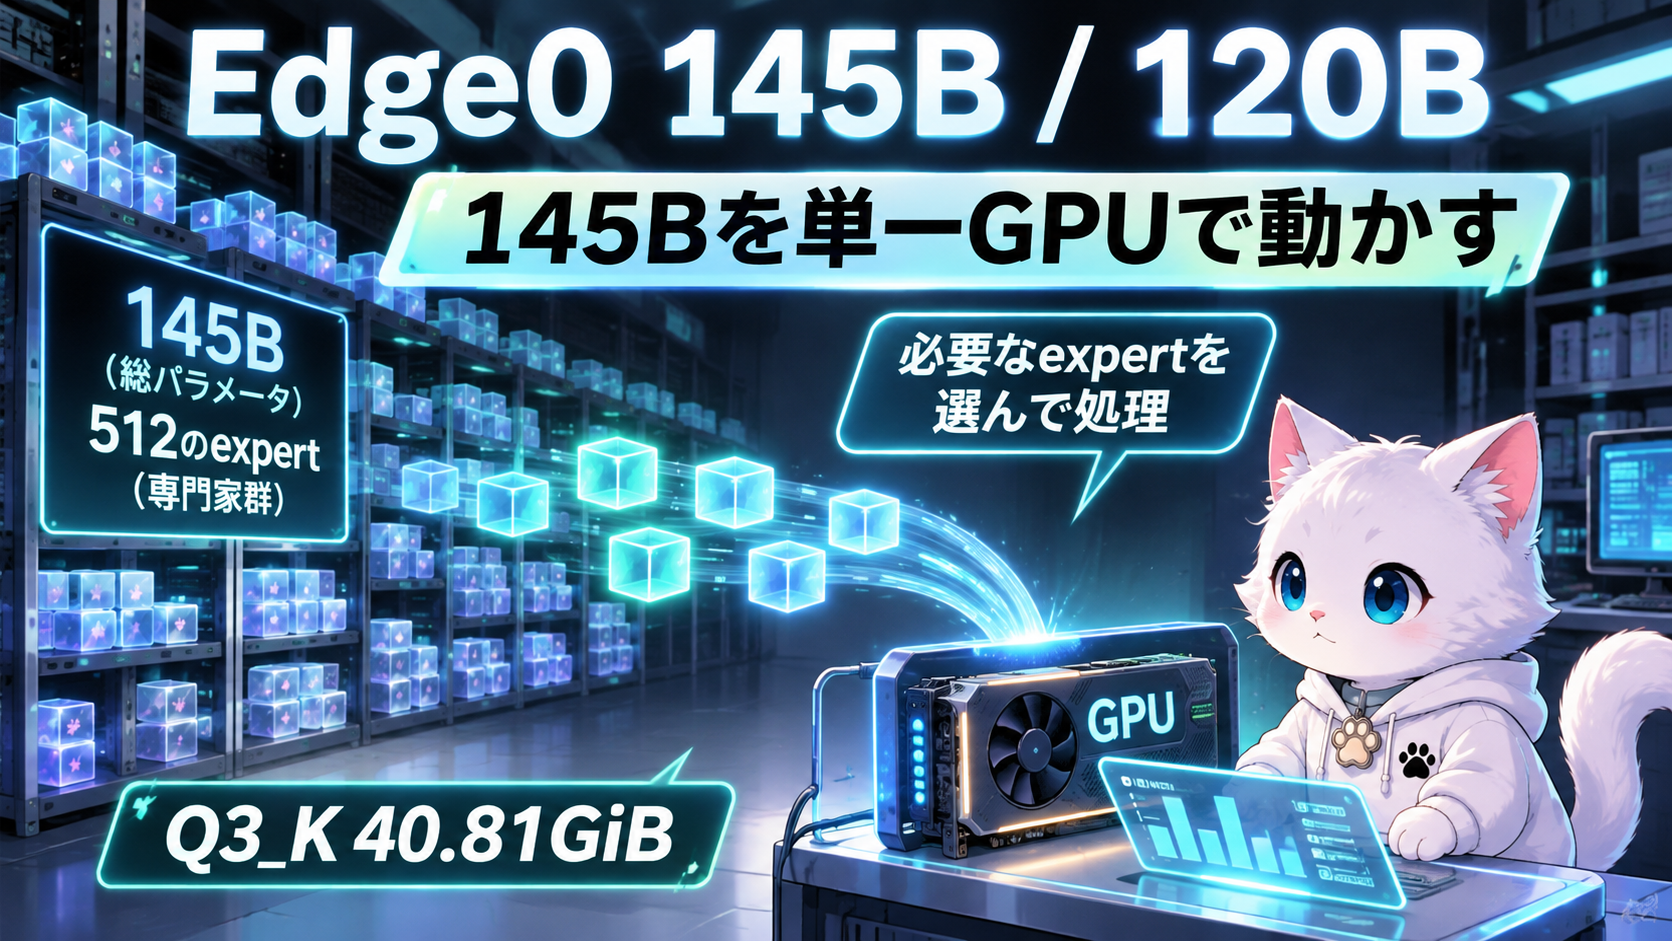
「145BのLLM」と聞くと、まず巨大なGPUメモリを想像するかもしれません。
ところが2026年11月13日、Edge0は145Bと120Bのモデルを単一NVIDIA GPUで動かすための新しいモデルと推論構成を公開しました。
公開されたのは、Qwen3.8-Flash-Nextをベースにしたlatent Mixture-of-Experts(MoE)のEdge0 145BとEdge0 120Bです。
重要なのは、「145Bの重み全部をGPUのVRAMへ詰め込む」という話ではないことです。
Edge0は多数のexpertのうち必要なものを選んで計算し、CPU・GPU・ホストメモリ間でデータを扱う専用のedge0-strataを利用します。
この記事では、なぜ145B級が単一GPUで動くのか、どれくらいのメモリを使うのか、普通のローカルAIユーザーが試す前に何を確認すべきかを整理します。
結論:モデル容量と必要VRAMは同じではない
Edge0 145BのQ3_K版は、公式資料で40.81GiBの重み容量とされています。
つまり、24GBや16GBのGPUに40.81GiBをそのまま全部載せることはできません。
それでも動かせる理由は、Edge0 145Bが145Bすべてを毎トークン計算するモデルではないからです。
公式仕様では総パラメータ145Bに対して、1トークンあたりのactive parametersは10.12B。512個のrouted expertsから10個を選び、shared expertと合わせて処理します。
必要なexpertをGPU側へ置き、残りをホスト側から扱うことで、モデル全体のサイズより小さいVRAM環境でも推論できる構成になっています。
これは「145Bが16GBに圧縮された」という意味ではありません。
VRAMだけを見るのではなく、重み容量・RAM・VRAM・データ転送をセットで考えるモデルです。
Edge0 145B / 120Bとは
今回公開された2モデルの主な仕様は次の通りです。
| 項目 | Edge0 145B | Edge0 120B |
|---|---|---|
| 総パラメータ | 145B | 120B |
| active / token | 10.12B | 8.64B |
| レイヤー | 48 | 48 |
| routed experts | 512 | 512 |
| 選択expert | 10 | 10 |
| context | 256K | 256K |
| Q3_K重み | 40.81GiB | 27.98GiB |
| NVFP4重み | 47.79GiB | 32.96GiB |
どちらもQ3_K版とNVFP4版が公開されています。
145Bの方が高性能を狙った構成で、120Bは重み容量を抑えながら同じ考え方で動かせるモデルです。
16GB VRAMでも動く、は「最低要件16GB」という意味ではない
公式ベンチマークには、かなり目を引く結果があります。
145B Q3_Kについて、16GiB VRAM+20GiB system RAMという制限をかけた環境で、chat decode 36.8 tok/s、agent decode 44.9 tok/sという測定値が掲載されています。
120B Q3_Kでは同じ制限条件で、chat decode 62.4 tok/s、agent decode 73.3 tok/sです。
ただし、ここは誤解しやすいところです。
公式も明記している通り、これはRTX 5090 D 24GBをcgroupで16GiB VRAM+20GiB RAMへ制限したテストです。
「16GB VRAMのGPUならどのPCでも同じ速度で動く」「必要RAMは20GBで確定」という最低動作要件ではありません。
ストレージ速度、PCIe、CPU、GPU、RAM構成などによって実際の性能は変わります。
24GB級GPUでは重みをVRAMとRAMへ分けている
公式のmemory residency値を見ると仕組みがさらに分かりやすくなります。
145B Q3_Kでは、40.81GiBの重みに対して、residency有効時の測定例が23.14GiB VRAM+31.28GiB RAM。
120B Q3_Kでは27.98GiBの重みに対して、22.93GiB VRAM+18.40GiB RAMです。
ここでVRAMとRAMの数字を単純に足して「モデル容量より大きい」と混乱する必要はありません。公式はexpert setsが重複計上されていないことを説明しており、推論に必要な周辺データも含む実行時の配置として見るべき数字です。
大事なのは、GPUだけですべてを抱える設計ではないことです。
なぜ巨大MoEを単一GPUで動かせるのか
MoEでは、毎回すべてのexpertを使う必要がありません。
Edge0 145Bの場合、各レイヤーに512個のrouted expertsがありますが、1トークンで選ばれるのは10個です。
Edge0の推論エンジンは、この疎な構造を利用して必要なexpertをGPU側へ置き、その他をホストメモリ側で扱います。
イメージとしては、巨大な145BモデルをGPUへ押し込むのではなく、
巨大な専門家の倉庫から、その瞬間に必要な専門家だけをGPUの作業台へ呼ぶ
という方が近いでしょう。
そのため、総パラメータ数だけを見て「このGPUでは絶対に動かない」と判断できないモデルになっています。
Windowsで試す場合の条件
2026年11月13日時点で、145B / 120Bの公式要件はLinuxまたはWindows、NVIDIA GPU、CUDA 13です。
推論にはedge0-inferと、145B / 120B向けのedge0-strataを利用します。
モデルフォルダを用意したあと、edge0-infer serveまたはedge0-infer chatから起動する構成です。
そのため、LM StudioでGGUFを選んでクリックするだけ、といった導入よりは技術的です。
初心者が試す場合は、少なくとも次を先に確認した方が安全です。
- NVIDIA GPUとVRAM容量
- system RAMの空き
- モデル重みを置くストレージ容量
- CUDA 13環境
edge0-strataを含む公式手順を扱えるか
特に145B Q3_Kだけでも重みは40.81GiBあるため、VRAMが足りるかだけでなく保存容量とRAM側の余裕も必要です。
速度の数字は「公式測定」として見る
公式には24GB級GPUを含む複数環境のベンチマークが公開されています。
たとえば145B Q3_Kは公式のRTX 4090 24GB測定でchat decode 69.9 tok/s、agent decode 91.7 tok/s、120B Q3_Kでは95.0 tok/s、104.9 tok/sです。
ただし、これはRossy Laboratoryで再現した数字ではありません。
モデル品質についても、deepswe、terminal-bench、GPQA-Diamondなどの公式評価値は掲載されていますが、本記事では「実際に日本語で使ってどの程度賢いか」まで断定しません。
ローカルLLMはモデルそのものだけでなく、量子化方式、推論エンジン、コンテキスト長、ハードウェア構成で体感が変わるためです。
どんな人に面白い?
Edge0 145B / 120Bが特に面白いのは、次のような人です。
- 大規模なローカルLLMを単一GPUで試したい
- MoEのメモリ節約が実際にどこまで効くか興味がある
- コーディングやagent用途のローカルモデルを探している
- VRAM容量だけでモデルを諦めていた
- RAMとGPUを組み合わせた推論構成を試したい
逆に、インストーラーを押すだけで使えるローカルAIを探している人には、現時点では少しハードルが高めです。
「145Bが16GB GPUで動く」の読み方に注意
今回の発表で一番インパクトがあるのは、巨大な145B級モデルを限られたGPUメモリ環境でも実行できることです。
ただし、ここから
「145Bモデルに必要なメモリは16GB」
と結論づけるのは正しくありません。
145B Q3_Kの重み自体は40.81GiBあります。
Edge0が面白いのは、その大きな重みをVRAMへ全載せしなくても推論できる仕組みを作っていることです。
ローカルAIの必要スペックを見るときは、これからますます
モデル容量 ≠ 必要VRAM
という考え方が重要になりそうです。
Edge0 145B / 120Bは、その違いが非常に分かりやすく現れた新しい例です。
最終確認:2026年11月13日。Edge0 145B / 120Bは公開直後のため、対応環境・推論エンジン・ベンチマークは今後更新される可能性があります。
SOURCES