RLR-0094 ・ 公開 2026/11/14 ・ 更新 2026/11/14
ComfyUIのローカルLLMが最大2倍高速化。Qwen3.xを速くするv0.45.0の使い方
ComfyUI v0.45.0ではQwen3.x系ローカルLLMのテキスト生成経路が高速化され、公式検証では同じcheckpoint・同じGPUで最大約2倍の生成速度が報告されています。Text Generateのmtp=auto、Comfy-Kitchen attention、対応範囲と注意点を初心者向けに整理します。
ローカルAIで画像や動画を作っていると、プロンプト補助や画像説明に使うLLMだけ妙に待たされることがあります。
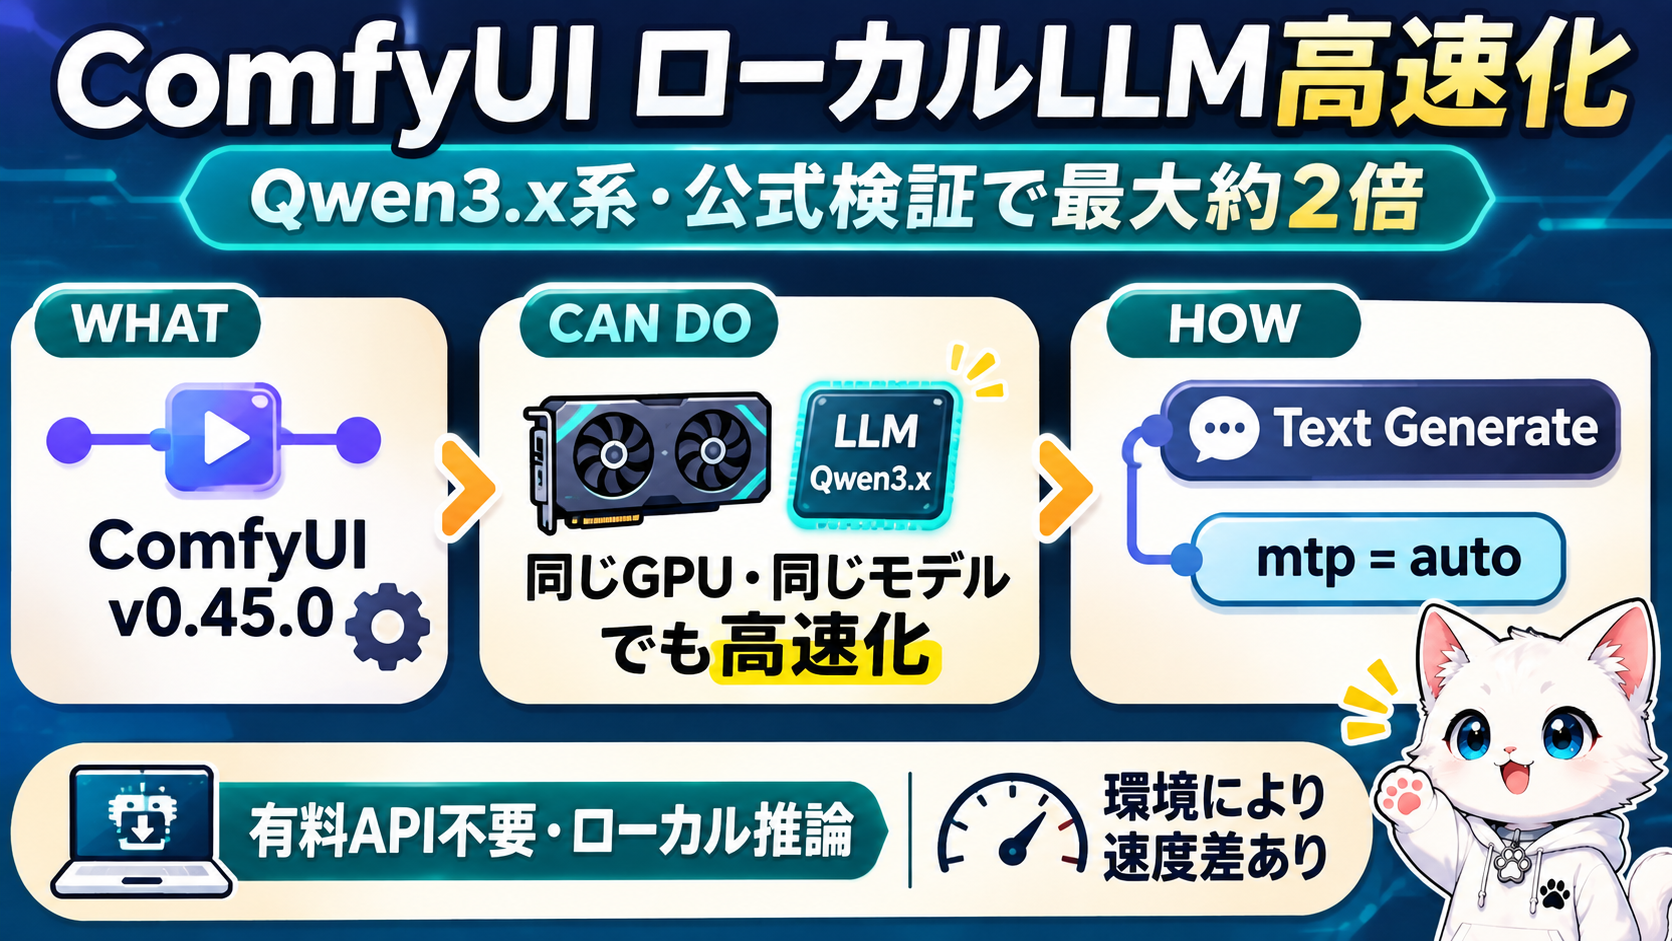
ComfyUIは2026年11月11日、Qwen3.x系のローカルLLM生成を高速化した新しい推論経路を解説しました。改善はComfyUI v0.45.0で利用でき、公式検証では同じcheckpoint・同じGPUのまま、テキスト生成が最大で約2倍になった例が報告されています。
ポイントは、新しいモデルへ乗り換える話ではないことです。
今使っているQwen3.x系checkpointを、ComfyUI側の改善でより速く動かすのが今回の更新です。
この記事では、何が速くなったのか、どう使うのか、そして「2倍」をどう読めばいいのかを整理します。
結論:まずComfyUI v0.45.0へ更新し、Text Generateのmtpをautoで使う
今回の高速化を試す基本手順はシンプルです。
- ComfyUIをv0.45.0以降へ更新する
- 対応するQwen3.x系checkpointを読み込む
Text Generateノードの**mtpをauto**のまま使う- 同じプロンプトで生成速度を確認する
ComfyUI公式は、v0.45.0ではQwen3.x系LLM向けの高速化が利用でき、基本的にはmtp=autoでよいと説明しています。
つまり、専用の有料APIやcreditsを購入する機能ではありません。自分のGPUで動かすローカルLLMの推論改善です。
どれくらい速くなった?
公式記事では複数の実測例が公開されています。
| 例 | 更新前 | 更新後 |
|---|---|---|
| Qwen3.5 9B / RTX 5090 | 106 tok/s | 219 tok/s |
| Qwen3.5 9B / RTX 5080 | 91 tok/s | 129 tok/s |
| Qwen3.8 27B 画像説明 / RTX 5090 | 55 tok/s | 122 tok/s |
RTX 5090上のQwen3.5 9Bでは106から219 tok/s、Qwen3.8 27Bの画像説明では55から122 tok/sという結果です。
ただし、ここは読み方に注意が必要です。
「すべてのPC・すべてのLLMが必ず2倍になる」という意味ではありません。
モデル、量子化方式、GPU、プロンプト長、処理内容によって伸び幅は変わります。公式の数値もRTX 5090や5080を使った例であり、RTX 4090や一般的なGPUで同じ数字になる保証はありません。
なぜ速くなったの?
LLMのテキスト生成は、画像生成とは少し違うボトルネックを持っています。
画像・動画の拡散モデルでは計算量そのものが重くなりやすい一方、LLMの1トークンずつの生成ではモデルの重みをVRAMからどれだけ効率よく読み出せるかが重要になります。
ComfyUIは今回、Qwen3.x系で使う線形演算の経路を見直し、VRAM上の重み配置と読み出しを高速化しました。
さらに**MTP(Multi-Token Prediction)**を使い、次のトークン候補を複数まとめて予測・検証する仕組みも改善しています。
ざっくり言えば、
GPUを交換したのではなく、同じGPUの中でLLMを走らせる道路を広げた
という更新です。
MTPはどう設定する?
通常はText Generateノードの**mtpをauto**にします。
公式もこの設定を基本として案内しています。対応モデルならComfyUI側が利用可能なMTP経路を使います。
そのため初心者が最初から細かなMTPパラメータを調整する必要はありません。
まずは、
v0.45.0以降へ更新 → Qwen3.xを読み込む → mtp=auto → 同じ入力で速度を見る
という順番で十分です。
長いプロンプトではComfy-Kitchen attentionも選択肢
v0.45.0ではLLM向けのattention経路にも改善が入っています。
ComfyUI公式によると、Comfy-Kitchen attentionとKV Cacheの組み合わせにより、LLM向けattentionでINT8を利用でき、長いプロンプトや既存コンテキストのprefill高速化とKV CacheのVRAM削減が期待できます。
この経路は起動時に、
--use-ck-attention
を付けて有効化できます。
ただし、これはまず全員が必ず変更すべき設定というより、長い入力を扱う人が追加で試す高速化として考えるのが分かりやすいでしょう。
画像生成ユーザーにも関係あるの?
あります。
最近の画像生成ワークフローでは、LLMを単独チャットに使うだけではありません。
- プロンプトを詳しく書き直す
- 画像を説明して次のプロンプトへ渡す
- ストーリーやシーン案を作る
- 画像生成モデル用のprompt enhancerとして使う
といった処理にもローカルLLMが組み込まれています。
そのためLLM部分が速くなると、画像そのものの生成時間が2倍速くなるわけではなくても、ワークフロー全体の待ち時間が短くなる可能性があります。
特に、画像を見て説明文を作り、その文章を次の生成へ渡すようなワークフローでは恩恵が分かりやすそうです。
更新前に知っておきたい注意点
1. 「最大2倍」は公式の特定条件での結果
今回の数字は公式ベンチマークです。自分のGPUで同じ倍率になるとは限りません。
更新前後を比べるなら、同じcheckpoint・同じ入力・同じ設定でtok/sを比較するのが確実です。
2. 主な対象はQwen3.x系
今回の公式解説はQwen3.xファミリーを中心にしています。
「ComfyUIで動くすべてのLLMが2倍」という更新ではありません。
3. 画像・動画生成そのものが2倍になるわけではない
高速化されるのはLLMのテキスト生成部分です。
拡散モデルによる画像生成や動画生成の速度とは分けて考える必要があります。
こんな人は試す価値あり
今回の更新は、次のような人と相性が良いです。
- ComfyUI内でQwen3.x系LLMを使っている
- prompt enhancerの待ち時間を短くしたい
- 画像説明から次の生成へつなぐworkflowを使っている
- ローカルLLMをAPI課金なしで高速化したい
- 同じGPUのまま推論速度を上げたい
特に面白いのは、モデルを変えなくてもComfyUI本体の更新だけで速度が変わる点です。
ローカルAIでは新モデルばかりに目が行きがちですが、推論エンジン側の改善も体感速度を大きく変えます。
すでにComfyUIでQwen3.xを使っているなら、まずv0.45.0以降へ更新し、Text Generateのmtp=autoで同じworkflowを走らせてみるのが一番分かりやすい確認方法です。
最終確認:2026年11月14日。速度値はComfyUI公式が公開した検証結果であり、環境によって変わります。
SOURCES