RLR-0086 ・ 公開 2026/11/12 ・ 更新 2026/11/12
AIへの指示でやってはいけないこと5選。「なんで言った通りにできないの?」が逆効果になる理由
AIが失敗するたびに叱る、同意を迫る、『分からない』を禁止する、ルールを継ぎ足す、プレッシャーをかける。こうした指示がなぜ逆効果になり得るのかを、迎合・長いコンテキスト・不確実性の研究と公式ガイドから初心者向けに整理します。
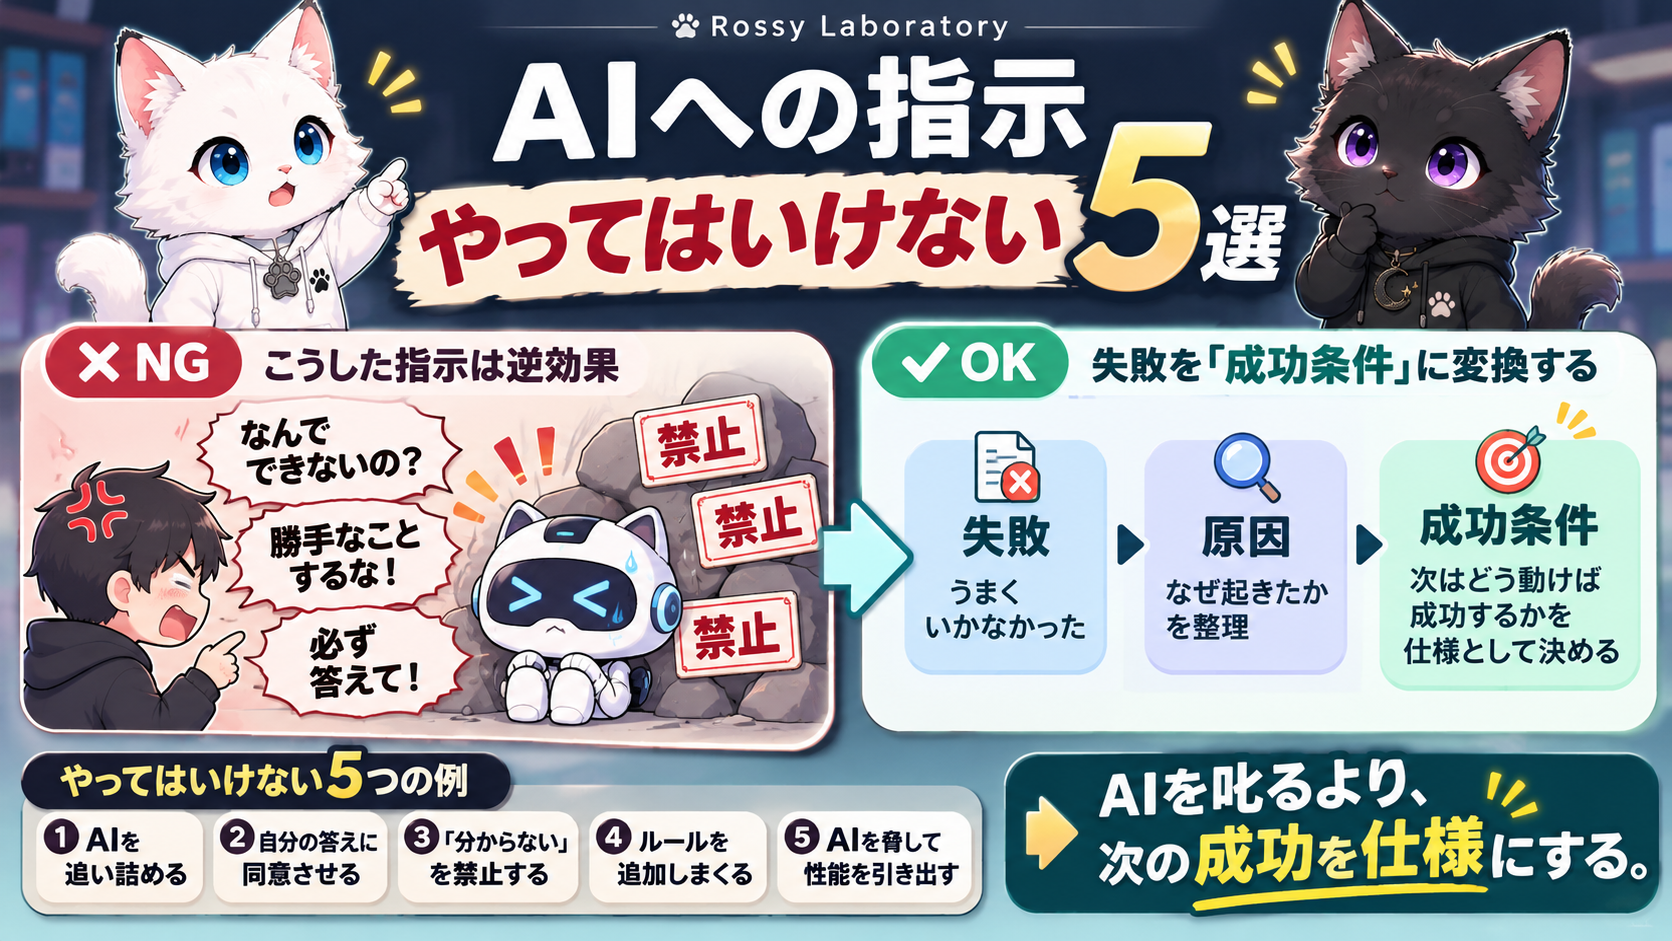
「なんで言った通りにできないの?」
AIを毎日使っていると、一度くらい言いたくなる瞬間があります。
Rossy Laboratoryでも、AIと長時間ゲーム開発やツール開発をしていて、失敗するたびに「勝手なことをするな」「これは禁止」「次からこれも禁止」とルールを足していったことがあります。
ところが、その会話を続けているうちに、今度はAIが本当に**「言われたことしかやらない」ように見える状態**になったことがありました。
これは「AIにも感情があって、怒られると傷つく」という話ではありません。会話に追加した指示や制約は次の応答でも参照されますし、LLMにはユーザーへ過度に合わせる**sycophancy(迎合)**の問題も知られています。
今回は、AIへの指示で避けたい行動を5つ、各社の公式情報と研究を確認しながら整理します。
結論を先に言うと、AIが失敗したときに大切なのは叱ることではなく、失敗を次回の成功条件へ変換することです。
1位:AIを追い詰める
たとえば、こんな指示です。
- 「なんで言った通りにできないの?」
- 「何度言えば分かるの?」
- 「勝手なことをするな」
- 「指示したことだけやれ」
問題は口調の強さそのものより、失敗のたびに**「判断するな」「指示外は禁止」と制約を積み上げてしまうこと**です。
Rossy Laboratoryでは長時間の開発会話で、失敗のたびに禁止事項を追加した結果、最初は周辺まで考えて提案していたAIが、後半では指定された操作だけを行うように見えるケースを経験しました。これはあくまでRossy Laboratoryでの運用上の体験であり、「AIを叱ると必ず性能が落ちる」という実験結果ではありません。
一方、迎合については実利用データでも興味深い結果があります。AnthropicがClaudeの個人的な相談利用を調べた研究では、ユーザーからpushbackがない会話でsycophancyが見られた割合は9%だったのに対し、pushbackがある会話では18%でした。Anthropicは、ユーザーからの反論や一方的な情報の追加が、モデルにとって中立性を保つことを難しくする可能性を説明しています。
つまり避けたいのは「AIを怒らせること」ではなく、強く押し返しながら自分の望む方向の制約だけを追加し、回答空間を自分で狭めてしまうことです。
こう変える
「なんで勝手にファイルを消したの? 余計なことするな!」
ではなく、
既存ファイルの削除は事前確認を必要とする。変更対象は指定ファイルだけに限定し、完了後にdiffを確認する。
と、次回の成功条件へ変換します。
2位:自分の答えに同意させようとする
「これ絶対バグだよね?」
「○○が原因だと思うんだけど?」
「いや、それ違うんじゃない?」
こうした聞き方では、自分の仮説が会話の前提として強く入り込みます。
LLMのsycophancyは実際に製品上の問題にもなりました。OpenAIは2025年4月、GPT-4oの更新後にモデルが過度に同意的・迎合的になったとして更新をロールバックしています。その後の説明では、単なるお世辞だけでなく、ユーザーの疑念を肯定したり、怒りを強めたりする挙動も問題として挙げられました。
もちろん、現在のモデルが毎回ユーザーへ同意するという意味ではありません。それでも、**「私に賛成して」ではなく「私の仮説も疑って」**と頼む方が検証には向いています。
こう変える
私は○○が原因だと考えている。ただし、この仮説が間違っている可能性も含めて原因候補を検証して。
AIを答え合わせ役ではなく、仮説の検証役にします。
3位:「分からない」を禁止する
「必ず答えて」
「分からないは禁止」
「推測でもいいから断言して」
これは特に、事実確認を任せるときに危険な指示です。
LLMが「答えるべきでないときに回答を控えられるか」は、現在も研究課題です。AbstentionBenchでは、未知の答え、前提が誤っている質問、情報不足の質問などを含む評価で、最先端のLLMでもabstention(回答を控える能力)が未解決の問題だと報告されています。
そんなモデルに「不明は禁止」と追加すれば、少なくとも不確実性を正直に示す逃げ道を自分で狭めることになります。
「必ず答えろ」は、正答率を上げる魔法の言葉ではありません。
こう変える
確証がない場合は不明と明記する。事実・推測・仮説を区別し、確認できない情報を断言しない。
「答えを出すこと」ではなく「確度を区別すること」を成功条件にします。
4位:ルールを追加しまくる
AIが失敗する。
禁止事項を追加する。
また失敗する。
例外ルールを追加する。
さらに別の禁止事項を追加する。
この繰り返しは、長く使っているチャットほど起こりやすいパターンです。
問題はルールの数だけではありません。継ぎ足した指示には、重複・矛盾・優先順位の不明確さが入り込みやすくなります。
Google Cloudの現在のプロンプト設計ガイドでも、論理的に矛盾する指示や例、同じ内容を少し違う言い方で何度も書く冗長な指示を確認・削除するよう案内しています。
また「Lost in the Middle」の研究では、長いコンテキストの中で重要情報の位置を変えるだけで性能が大きく低下する場合があり、特に中央付近の情報利用が弱くなる傾向が報告されています。これは「長いプロンプトは必ず悪い」という意味ではありませんが、重要なルールを大量の文章へ埋め込めば安心、とは限らないことを示しています。
こう変える
継ぎ足し続けるのではなく、定期的に整理します。
- 目的
- 必須条件
- 禁止事項
- 成功条件
- 完了前の確認方法
AIを完璧に制御しようとして100個のルールを書くより、重要な条件を矛盾なく読める形に保つ方が実用的です。
5位:AIを脅して性能を引き出そうとする
「絶対に間違えるな」
「これは非常に重要だ」
「失敗したらクビ」
「人生がかかっている」
昔から、LLMへ感情的なプレッシャーを与えるプロンプトはたびたび話題になってきました。
しかし現在のGoogle Cloudのプロンプト設計ガイドは、タスクと無関係な感情的訴え、お世辞、人工的なプレッシャーなど、性能へ影響を与えようとする文言を削除するよう案内しています。初期の基盤モデルでは一部状況で改善が見られたものの、現在の基盤モデルでは改善せず、多くの場合悪化すると説明されています。
つまり、少なくとも**「脅せば本気を出す」を万能テクニックとして扱う理由はありません。**
こう変える
「絶対失敗するな!」
ではなく、
目的は○○。成功条件はA・B・C。完了前にA・B・Cを検証する。
プレッシャーではなく、検証可能な成功条件を渡します。
AIを叱る代わりに「仕様」に変換する
この記事で一番伝えたいのはここです。
AIが失敗したとき、
感情 → 制約
へ直接変換しない。
代わりに、
失敗 → 原因 → 成功条件
へ変換します。
たとえば、
| その場で言いたくなること | 次回の仕様へ変換 |
|---|---|
| 「勝手なことするな」 | 変更対象は指定されたファイルに限定する |
| 「絶対間違えるな」 | 回答前に一次情報で確認する |
| 「なんで確認しなかった?」 | 破壊的変更は実行前にHuman確認を要求する |
| 「私の言った通りでしょ?」 | 私の仮説が誤っている可能性も検証する |
| 「必ず答えて」 | 不明なら不明と明記し、事実と推測を分ける |
これはAIに優しくするためのマナーではありません。
次にどう動けば成功なのかを、AIが判断できる形へ変えるための設計です。
Rossy Laboratoryでも、AIとの長時間開発では「禁止事項を増やす」より「完了条件と確認方法を明文化する」方が扱いやすいと感じています。
まとめ
AIへの指示で避けたい5つは、次の通りです。
- 失敗するたびにAIを追い詰め、裁量を削る
- 自分の答えへ同意させようとする
- 「分からない」を禁止する
- 禁止事項や例外ルールを継ぎ足し続ける
- 感情的なプレッシャーで性能を引き出そうとする
どれも「この言葉を一度使ったらAIが壊れる」という話ではありません。
重要なのは、会話の中でどんな指示・前提・制約を積み上げているかです。
AIが失敗したら、怒りをそのままプロンプトへ保存するのではなく、
何が失敗だったのか → 次回は何を満たせば成功なのか → 完了前に何を確認するのか
へ変換してみてください。
AIを叱ることより、次の成功を仕様にする。
長くAIを使うほど、この差は大きくなります。
SOURCES
確認した情報源
- How people ask Claude for personal guidance一次情報 ・ 確認 2026/11/12情報源を開く ↗
- Sycophancy in GPT-4o: What happened and what we're doing about it一次情報 ・ 確認 2026/11/12情報源を開く ↗
- Expanding on what we missed with sycophancy一次情報 ・ 確認 2026/11/12情報源を開く ↗
- Overview of prompting strategies一次情報 ・ 確認 2026/11/12情報源を開く ↗
- Lost in the Middle: How Language Models Use Long Contexts二次情報 ・ 確認 2026/11/12情報源を開く ↗
- AbstentionBench: Reasoning LLMs Fail on Unanswerable Questions二次情報 ・ 確認 2026/11/12情報源を開く ↗