RLR-0084 ・ 公開 2026/11/11 ・ 更新 2026/11/11
MiniMax H3-Image正式公開!16MP直接生成・最大16枚参照、ローカル導入の注意点
MiniMaxが2026年11月11日に公開したopen-weight画像生成モデル「H3-Image」を初心者向けに整理。約16MPの直接生成、最大16枚の参照画像、画像生成と編集の統合、モデル容量とローカル利用に必要な環境の注意点を解説します。
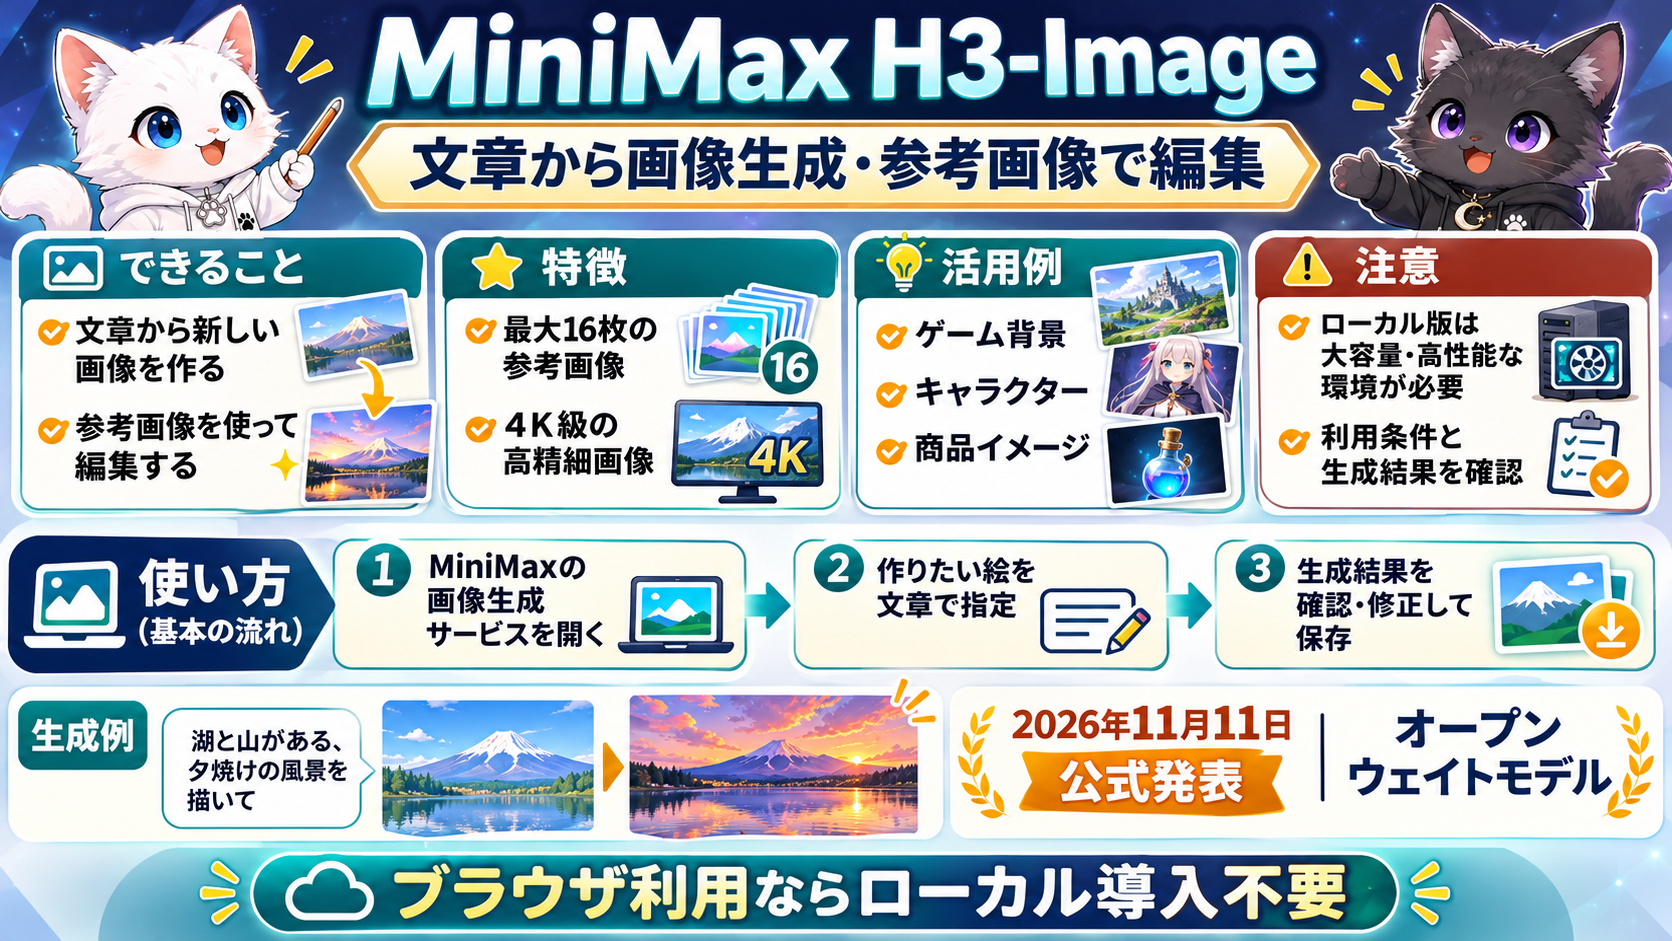
MiniMaxから、画像生成AIの新モデル 「MiniMax H3-Image」 が2026年11月11日に正式公開されました。
今回のポイントは、単に「新しい画像AIが増えた」というだけではありません。約16メガピクセルの高解像度画像を直接生成でき、テキストからの画像生成と画像編集を1つのモデルで扱い、最大16枚の参照画像にも対応しています。
しかもモデルの重みは公開されており、ローカル環境で試すための手順も公式モデルカードに用意されています。
ただし、ここで注意したいのが必要な容量です。H3-Image本体だけでも約68.65GBあり、さらにMiniMax-H3のtext encoder約66.7GBを利用します。一般的なPCで気軽にローカル実行するにはかなり大きな構成なので、必要なストレージやGPUメモリ、offloadや量子化などの実行方法を確認してから導入する必要があります。
この記事では、H3-Imageで何ができるのか、従来の画像生成AIと比べて何が面白いのか、ローカルで試す前に何を確認すべきかを初心者向けに整理します。
H3-Imageは何が新しい?
H3-Imageは、MiniMax H3ファミリーをベースにした画像生成・編集モデルです。
公式モデルカードでは、主に次の特徴が紹介されています。
- テキストから画像を作るText-to-Image
- 既存画像を使った画像編集
- 最大16枚の参照画像
- 約16MPの高解像度画像を直接生成
- 6 sampling steps
- 画像生成と編集を1つのcheckpointに統合
特に分かりやすい特徴が解像度です。
1:1なら 4096×4096、16:9なら 5472×3072、21:9なら 6272×2688 など、約16MPの画像を直接生成できます。
公式モデルカードでは、これは別のアップスケーラで後から拡大する方式ではなく、H3-Image自身がそのサイズで生成すると説明されています。対応範囲はおよそ4MPから20MPで、公式は約16MP付近を特に推奨しています。
最大16枚の画像を参照できる
もう1つ面白いのが、最大16枚の参照画像を扱えることです。
たとえば、キャラクター、服、小物、背景、家具など複数の画像を材料として渡し、それらを踏まえた画像編集や生成に利用できます。公式の紹介では、空の部屋と複数の家具画像を参照して室内を構成する例などが示されています。
ただし「16枚渡せば必ずすべての特徴を完全に維持できる」という意味ではありません。参照画像が増えたときの再現性や細部の保持は、実際の用途ごとに確認する必要があります。
画像生成と画像編集が同じモデル
H3-Imageでは、Text-to-Imageと画像編集が同じcheckpointにまとめられています。
文章だけから新しい画像を作るだけでなく、手元の画像を参照しながら変更する使い方も同じモデルで扱えます。
公式モデルカードでは、参照画像を <Picture 1>、<Picture 2> のようにプロンプトから指定する仕組みも説明されています。生成と編集を別モデルへ切り替える必要がないため、制作ワークフローをまとめやすいのも特徴です。
6 stepsで生成する設計
H3-Imageは 6 sampling steps にdistillされています。
公式のローカルサーバー向け仕様では、num_inference_steps は6、guidance_scale は1を使用します。negative promptには対応していません。
MiniMaxは公式発表で、4K(4096×4096)の画像を10秒未満で生成できると紹介しています。
ただし、この速度を一般的な個人PCでのローカル実測値と考えないよう注意してください。公式発表の速度と、自分のPCへopen-weightモデルを導入した場合の速度は分けて考える必要があります。
ローカルで試す前に容量を確認
公式モデルカードに記載されている主な容量は次の通りです。
| コンポーネント | 公式記載の容量 |
|---|---|
| MiniMax-H3-Image 全体 | 約68.65GB |
| └ Diffusion Transformer部分 | 約66.28GB |
| └ Image VAE部分 | 約2.34GB |
| MiniMax-H3 text encoder | 約66.7GB |
| H3-Image-PE(任意) | 約17.9GB |
H3-Imageのリポジトリだけを見て「約69GBのモデル」と考えると不足します。公式の標準構成では、MiniMax-H3側のtext encoderも利用します。すでにMiniMax-H3を導入していてtext encoderを持っている場合は再ダウンロードする必要はありません。
任意の MiniMax-H3-Image-PE は短いプロンプトを詳細な画像説明へ展開するためのPrompt Expanderです。
普通のPCでローカル利用できる?
H3-Imageはopen-weightですが、一般的なPCで気軽にローカル実行できる小型モデルではありません。 本体に加えてtext encoderも利用するため、まずストレージ容量と実行環境を確認する必要があります。
ただし、モデルファイルの合計容量と必要VRAMは同じではありません。
CPU offload、複数GPU、量子化、実行フレームワークなどによって必要なVRAMは変わります。そのため、特定のGPU容量だけを見て「動く・動かない」と一律に判断するのは正確ではありません。
公式モデルカードのローカルデプロイ例では複数GPUを使う構成が案内されています。手元のPCで試したい場合は、量子化版やComfyUI対応、offload経路などを確認し、自分の環境に合う方法があるかを先に調べるのが現実的です。
難しそうな場合は、まずオンライン版で機能や生成結果を確認してからローカル導入を検討すると分かりやすいでしょう。
短い日本語プロンプトはどうなる?
MiniMaxのオンラインAPIでは、短いプロンプトを H3-Image-Context-IR で詳細な画像説明へ展開してから生成する仕組みが用意されています。
ローカルでは、任意の MiniMax-H3-Image-PE を利用できます。
つまり、オンライン版とopen-weightモデルを単純に同じ条件で比較すると、プロンプト処理の違いが結果へ影響する可能性があります。ローカルで画質を比較するときは、画像モデル本体だけでなく「どのようにプロンプトを展開したか」も確認した方がよいでしょう。
どうやって試せる?
公式情報では、H3-Imageは複数の方法で利用できます。
すぐ試したい場合はMiniMaxのオンラインサービス、開発者向けにはAPI、open-weightモデルを自分で扱いたい場合はHugging Faceから取得できます。公式モデルカードにはDiffusersに加えてローカルデプロイ手順も掲載されています。
一方で、ローカル利用はダウンロード容量も計算資源も小さくありません。初心者が「とりあえず数枚作ってみたい」場合はオンライン版から確認し、ローカル運用を目的にする場合はストレージ、VRAM、offloadや量子化の対応状況を先に調べるのが安全です。
ライセンスも確認しておこう
H3-Imageはopen-weightとして公開されていますが、何でも無条件に利用できるという意味ではありません。
公式モデルカードでは MiniMax-H3-Image Community License Agreement が適用されると明記されています。特に商用利用、サービスへの組み込み、配布などを考えている場合は、利用前に最新のライセンス本文を確認してください。
まとめ
MiniMax H3-Imageは、約16MPの直接生成、最大16枚の参照画像、画像生成と編集の統合、6 stepsという特徴を持つ新しいopen-weight画像生成モデルです。
高解像度を後段のアップスケーラ任せにせず直接生成できることや、多数の参照画像を扱えることは、ローカル画像生成を試している人にとってかなり気になるポイントです。
一方で、本体約68.65GBに加えて約66.7GBのtext encoderを利用する大きな構成です。ローカルで使いたい場合は、手元のPCで利用できる量子化やoffloadなどの実行方法を確認してから導入する必要があります。
まずは「高解像度で何が変わるのか」「複数参照が自分の制作に役立つのか」を見極めてから、ローカル導入を検討するのがよさそうです。
参考にした一次情報
- MiniMax Research「MiniMax H3-Image: Bringing 4K Image Generation into the 10-Second Era」
- Hugging Face「MiniMaxAI/MiniMax-H3-Image」
最終情報確認: 2026年11月11日。モデル仕様・提供方法・ライセンスは今後変更される可能性があります。
SOURCES