RLR-0090 ・ 公開 2026/11/13 ・ 更新 2026/11/13
ZONOS3-Miniとは?ブラウザでも動く音声クローン対応オープンTTSを解説
ZyphraのZONOS3-Miniは100M active / 800M totalのオープンTTS。43言語、ゼロショット音声クローン、声質・感情・話速の制御、WebGPUやCPU・CUDA・Metal・Vulkan向けruntimeに対応します。日本語利用時の確認点とローカル導入条件を整理します。
ローカルで音声生成AIを使いたい。でも、大きなGPUを前提にしたモデルは少し重い。
そんな人に面白い選択肢が登場しました。
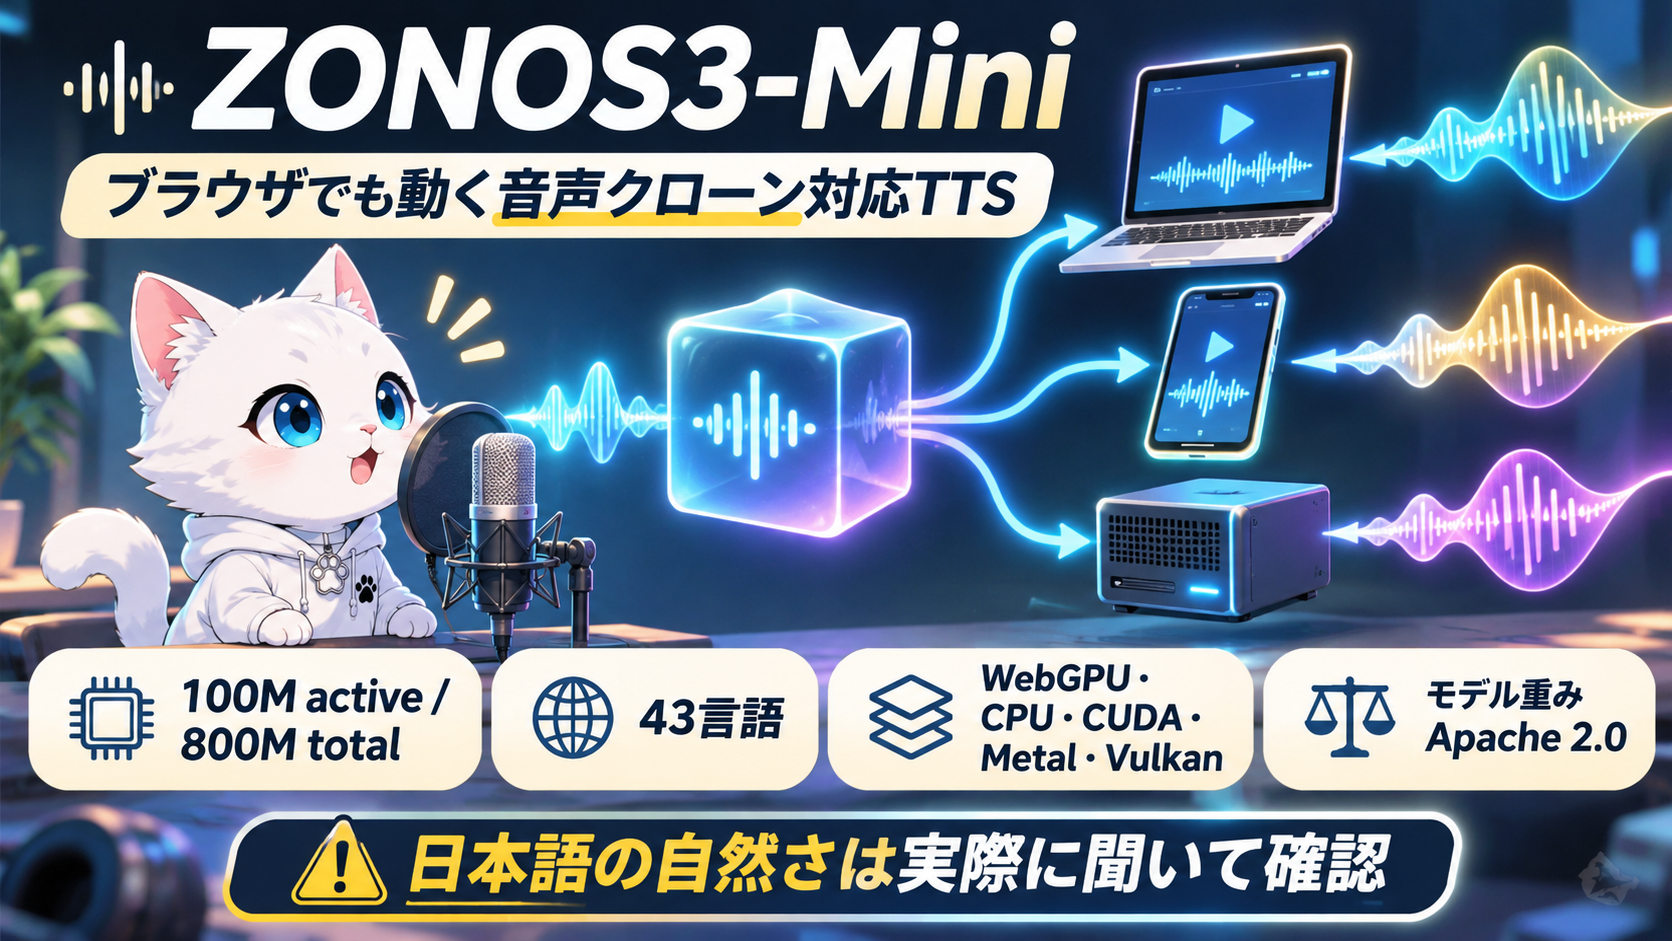
Zyphraが公開したZONOS3-Miniは、100M active / 800M total parametersの小型なオープンTTSです。
特徴はサイズだけではありません。
- 43言語の音声合成
- ゼロショット音声クローン
- 感情・声質・話速などの制御
- ブラウザ上のWebGPU実行
- CPU / CUDA / Metal / Vulkan向けruntime
- 44.1kHz音声
- Apache 2.0のモデル重み
まで公開されています。
ZyphraはPixel 9のブラウザでtime-to-first-audioが570ms未満、M3 MacBook Airでは150ms未満だったと報告しています。
この記事では、ZONOS3-Miniで何ができるのか、普通のPCやブラウザでも使えるとはどういう意味なのか、日本語で試すときに何を確認すべきかを整理します。
結論:巨大GPUだけを前提にしないローカル音声AI
ZONOS3-Miniの一番面白いところは、音声クローン対応TTSを幅広い端末へ持っていこうとしていることです。
公式runtimeには、
| 環境 | 公式runtime |
|---|---|
| ブラウザ | WebGPU |
| CPU | C++ / ggml |
| NVIDIA GPU | CUDA |
| Apple Silicon | MLX / Metal |
| その他GPU | Vulkan対応ggml |
| サーバー | SGLang系runtime |
が用意されています。
つまり「特定のハイエンドGPUを持っている人だけがローカルで試すモデル」ではありません。
もちろん端末によって生成速度や使える機能は変わります。
それでも、ブラウザ・スマートフォン・ノートPC・ローカルサーバーまで同じTTSを展開する設計は、これまでの大型音声モデルとはかなり違います。
100M active / 800M totalとは?
ZONOS3-MiniはMixture-of-Experts、いわゆるMoE構造を採用しています。
モデル全体では約800M parametersありますが、1トークンの処理で実際に使われるのは約100M parametersです。
ここで注意したいのは、
「100M activeだからモデルファイルも100M相当」という意味ではない
ことです。
公式GitHubでは、CUDA server向けのPyTorch weights一式はデフォルトdecoder込みで約9GBと案内されています。
一方、MLX、ggml、ブラウザ版ではGGUFやWeb向けの別形式を使います。
ローカルAIでは「パラメータ数」と「保存容量」と「実行時に必要なメモリ」を同じ数字として扱わないことが大切です。
ブラウザだけでも動かせる
ZONOS3-MiniにはWebGPU版runtimeがあります。
公式GitHubでは、WebGPU対応ブラウザならサーバーなしでブラウザ内実行できる構成が公開されています。
Zyphraの公式測定では、
- Pixel 9:time-to-first-audio 570ms未満
- M3 MacBook Air:150ms未満
とされています。
これは「文章全体を0.57秒で読み終える」という意味ではありません。
生成を開始してから最初の音声が出るまでの時間です。
ストリーミングTTSでは、全文生成が終わるまで待たず、生成できた音声から再生を始められるため、この値が小さいほど会話型AIなどで待ち時間を感じにくくなります。
なお、この数値はZyphraによる特定端末での公式測定です。すべてのスマートフォンやPCで同じ速度になるわけではありません。
43言語に対応、日本語も対象
公式技術記事では、ZONOS3-Miniは43言語の音声合成に対応すると説明されています。
さらにHugging Faceのモデルカードでは、推論時のtext normalization対象として、
- English
- Mandarin
- Japanese
- Korean
- German
- Spanish
- French
- Italian
- Portuguese
などが明記されています。
つまり日本語テキストを処理する仕組み自体は公式runtimeへ組み込まれています。
ただし、ここは重要です。
Rossy Laboratoryでは今回、日本語の自然さ・アクセント・固有名詞・長文安定性を実測していません。
「日本語対応」と「日本語が自分の用途で十分自然」は別です。
日本語ナレーションや動画制作へ採用するなら、短文だけで判断せず、数字、英字混在、固有名詞、長文なども実際に聞いて確認するのがおすすめです。
音声サンプルから声をクローンできる
ZONOS3-Miniはzero-shot voice cloningに対応しています。
公式runtimeでは大きく2種類の方法があります。
Speaker embedding
参照音声から話者特徴を192次元のembeddingへ変換して使う方法です。
保存したembeddingを再利用できるため、毎回参照音声を読み込まなくても同じ声を呼び出せます。
Raw reference
参照音声そのものをcodec tokenへ変換し、生成時のcontextへ入れる方法です。
公式技術記事では最大60秒のreference clipを扱えるとされています。
Zyphraは、raw reference方式では参照音声の話し方を機械的にコピーするのではなく、より自然なprosodyを狙う設計だと説明しています。
動画のナレーター、ゲームキャラクター、音声アシスタントなど、同じ声を継続して使いたい制作と相性があります。
なお、本人の同意がない声のクローンや、他人になりすます用途には使わないでください。
感情・話速・声質も調整できる
ZONOS3-Miniは「声を似せる」だけではありません。
公式には、
- identity
- accent
- quality
- mood
- delivery
- loudness
- bandwidth
- speaking rate
などの制御が案内されています。
さらにword-level delivery controlも用意されています。
ゲームならセリフの一部だけ囁く、ナレーションなら重要語を強調する、といった使い方につながります。
ただし、利用できる制御はruntimeや追加ファイルによって異なります。
「モデル本体を入れれば全機能が自動で使える」とは限らない点に注意してください。
音声は44.1kHz
ZONOS3-Miniは独自のZAC-1 audio codecを使い、44.1kHzの音声を生成します。
特徴的なのはcodecのframe rateが15Hzと低いことです。
Zyphraは以前のZONOS2が86Hz codecと8B backboneを使っていたのに対し、ZONOS3-Miniではcodecとモデル構造の両方を軽量化しています。
生成するaudio tokenの頻度を減らしつつ品質を維持し、リアルタイム実行しやすくする設計です。
Windowsでは何を選ぶ?
Windows PCで試すなら、まず候補になるのがC++ / ggml runtimeです。
公式GitHubではggml server / CLIが、
- CPU
- CUDA
- Metal
- Vulkan
に対応すると案内されています。
Windows向けlauncherの記載もあります。
一方、公式のCUDA server手順はLinux x86_64 + NVIDIA GPUを中心に説明されています。
Windowsだから必ずPython + CUDA版を選ぶのではなく、まずggml版を確認する方が分かりやすいでしょう。
GGUF一式をすべて取得すると、公式READMEではfull-size decoder込みで約9.3GBとされています。
必要な機能だけなら構成は変えられるため、「9.3GBが絶対必要」とは限りません。
インストールしたくないならWebGPU版から
ローカルAIに慣れていない人は、最初からPython環境を作る必要はありません。
Zyphraはブラウザで試せるWebGPU Voice Studioを公開しています。
まずそこで、
- 自分のブラウザ・端末で動くか
- 日本語の発音が用途に合うか
- 音声クローンの雰囲気
- 生成速度
- steeringの効果
を確認してから、ローカルruntimeを導入する方が安全です。
「モデルを試すために環境構築で1時間使う」を避けられるのは大きな利点です。
ライセンスは?
ZONOS3-Miniのモデル重みはApache 2.0で公開されています。
公式runtime / reference codeはMIT Licenseです。
ただし、repository内には第三者コンポーネントも含まれます。
商用利用や再配布を行う場合は、モデル本体だけでなく、実際に組み込むruntime・依存ライブラリ・追加モデルのライセンスも確認してください。
また、音声クローンではライセンスとは別に、参照する声そのものの権利や本人同意も必要です。
Pocket TTS 4.0とは何が違う?
Rossy LaboratoryではRLR-0067で、CPUで動く小型音声モデルPocket TTS 4.0を紹介しました。
Pocket TTS 4.0の記事では、18M / 7M / 2Mという非常に小さなモデルを使い、GPUなしで英語音声を生成することが中心でした。
ZONOS3-Miniは方向性が違います。
- 43言語
- 日本語text normalization
- zero-shot voice cloning
- voice steering
- WebGPU
- CPU / GPU / Apple Silicon向け複数runtime
など、音声制作やリアルタイム音声エージェントまで広げる機能を持っています。
単純な最小サイズ競争ではなく、「小型化しながら制作機能をどこまで残せるか」というモデルです。
どんな人に向いている?
特に相性が良さそうなのは次の用途です。
- ローカルでTTSを試したい
- AI動画のナレーションを作りたい
- ゲームキャラクターへ声を付けたい
- 同じ話者の声を繰り返し使いたい
- 音声アシスタントを作りたい
- ブラウザ内で音声AIを動かしたい
- 大型GPUだけに依存しない構成を試したい
一方、日本語ナレーション品質を最優先する場合は、ZONOS3-Miniだけで決めず、普段使っている日本語TTSと実際に聞き比べるのが良いでしょう。
まとめ
ZONOS3-Miniの面白さは「100M active」という数字だけではありません。
音声クローンと細かな声の制御を持つTTSを、ブラウザ・スマートフォン・ノートPC・CPU・GPUへ広げようとしていることが本質です。
特にWebGPU版があるため、ローカルAI初心者でも「まずブラウザで試す」という入口があります。
一方で、日本語品質は用途ごとの実聴確認が必要です。
Rossy Laboratoryでも今回は公式仕様を確認した段階で、日本語音質を実測したわけではありません。
気になる人は、まずWebGPU版で短い日本語を読ませてみて、自分の用途に合うか確認するところから始めるのが良さそうです。
参考
最終確認: 2026年11月13日。ZONOS3-Miniは公開直後のため、runtime、GGUF、対応機能、導入手順は更新される可能性があります。導入時は最新の公式READMEを確認してください。
SOURCES